Danh mục: Hướng dẫn chung

  • Cài Đặt Omnigent Trên VPS Tự Host AI Agent Chuẩn Kỹ Thuật Từ A-Z

    Cài Đặt Omnigent Trên VPS Tự Host AI Agent Chuẩn Kỹ Thuật Từ A-Z

    Cài đặt Omnigent trên VPS là giải pháp tối ưu giúp bạn vận hành một lớp điều phối đa tác nhân AI (meta-harness) tập trung, hoạt động bền bỉ 24/7 mà không phụ thuộc vào tài nguyên máy tính cá nhân. Khi nhu cầu tích hợp Claude Code, Codex, Cursor hay các trợ lý mã nguồn mở ngày càng tăng, việc thiết bị cục bộ bị treo hoặc ngắt kết nối giữa chừng trở thành rào cản lớn. Một hệ thống máy chủ ảo ổn định từ ThueVPSGiaRe.vn sẽ mang đến nền tảng thực thi độc lập, cho phép bạn quản lý, cộng tác và giám sát tác vụ AI từ bất kỳ đâu.

    Omnigent là gì? Tổng quan về nền tảng Meta-Harness cho AI Agent

    Omnigent là một framework mã nguồn mở đóng vai trò lớp điều phối chung (meta-harness) cho toàn bộ các trợ lý AI lập trình hiện nay. Nền tảng này cho phép người dùng gom các agent độc lập như Claude Code, Codex, Cursor, OpenCode trên máy chủ, Hermes Agent hay Pi vào chung một quy trình làm việc duy nhất mà không cần viết lại mã nguồn.

    • Đồng bộ phiên làm việc đa nền tảng: Bạn có thể bắt đầu phiên tương tác từ giao diện dòng lệnh (CLI), tiếp tục theo dõi trên trình duyệt máy tính hoặc kiểm tra tiến độ ngay trên điện thoại thông minh thông qua Web UI đáp ứng chuẩn di động.
    • Giám sát và kết hợp đa tác nhân: Hỗ trợ điều phối nhiều agent cùng xử lý một vấn đề; ví dụ một agent phụ trách viết code và một agent từ nhà cung cấp khác thực hiện phản biện (code review).
    • Hỗ trợ kết nối sandbox linh hoạt: Khả năng tích hợp mạnh mẽ với các môi trường cô lập trên đám mây như Modal, Daytona, E2B, cụm container Kubernetes hoặc OpenShell để kiểm thử mã nguồn an toàn.
    • Hợp tác thời gian thực: Chia sẻ link phiên làm việc trực tiếp để đồng nghiệp cùng tham gia gõ lệnh (co-drive) hoặc rẽ nhánh (fork) thảo luận độc lập.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Máy chủ tối ưu cho Automation & AI Agent

    Vận hành các bộ điều phối AI Agent liên tục đòi hỏi ổ cứng đọc ghi nhanh và đường truyền mạng ổn định. Gói VPS tại Fast Byte cung cấp nền tảng ảo hóa riêng biệt giúp agent chạy bền bỉ với chi phí tối ưu nhất.

    Tham khảo VPS giá rẻ

    Yêu cầu hệ thống và chuẩn bị khi cài Omnigent trên VPS

    Trước khi tiến hành cài đặt Omnigent trên VPS, máy chủ của bạn cần đáp ứng đầy đủ các gói thư viện cơ sở. Việc chuẩn bị đúng cấu hình môi trường giúp tiến trình dựng agent diễn ra suôn sẻ và tránh gặp lỗi cô lập tiến trình.

    • Hệ điều hành: Khuyến nghị sử dụng các bản phân phối Linux như Ubuntu 22.04 LTS hoặc Ubuntu 24.04 LTS với đầy đủ quyền hạn root trên hệ thống để cấu hình sandbox.
    • Python: Omnigent yêu cầu Python 3.12 trở lên làm nền tảng cốt lõi. Bên cạnh đó, bộ cài đặt chính thức liệt kê các công cụ cần thiết như sau — bạn nên kiểm tra từng mục trước khi bắt đầu:
    • uv (bắt buộc): trình cài đặt sẽ tự đề nghị thiết lập cho bạn nếu chưa có.
    • git (bắt buộc): cần cho việc tải mã nguồn và các thao tác build.
    • Node.js 22 LTS trở lên kèm npm (dùng cho các coding-harness CLI mà omnigent run cài đặt) và pnpm (dùng cho web UI). Bạn có thể cài cả hai từ một bản Node duy nhất; pnpm có sẵn qua corepack enable hoặc npm install -g pnpm. Nếu chưa quen, hãy tham khảo cách cài Node.js 22 kèm npm trên Ubuntu trước khi tiến hành.
    • tmux: cần cho các terminal wrapper native như omnigent claude, omnigent codex, omnigent cursor, omnigent devin, omnigent hermes, omnigent kiro, omnigent pi (cài bằng apt install tmux; installer cũng đề nghị cài hộ bạn).
    • bubblewrap (bwrap) — chỉ dành cho Linux: các terminal wrapper native và harness pi bọc terminal của agent trong sandbox bwrap; trên Linux sự cô lập này là bắt buộc, thiếu binary bwrap sẽ khiến terminal không khởi động được (apt install bubblewrap; installer đề nghị cài hộ). macOS dùng sandbox seatbelt có sẵn nên không cần thêm gì.
    • Tùy chọn — Devin CLI: dùng cho lệnh omnigent devin, cài bằng curl -fsSL https://cli.devin.ai/install.sh | bash rồi đăng nhập devin auth login.
    • Tùy chọn — Kiro CLI: dùng cho lệnh omnigent kiro, cài bằng curl -fsSL https://cli.kiro.dev/install | bash rồi đăng nhập Kiro.
    • Tùy chọn — Databricks: nếu muốn dùng workspace Databricks làm model provider, cài Omnigent kèm extra databricks; đăng nhập workspace cũng dùng Databricks CLI.

    Lưu ý cho Windows: Omnigent chạy natively trên Windows ở chế độ “degraded”. Script bootstrap install_oss.sh chỉ hỗ trợ POSIX, nên trên Windows bạn cài trực tiếp bằng uv. Các tính năng hoạt động gồm omnigent server, web UI và các harness dựa trên SDK; còn các terminal wrapper tmux/PTY native và sandbox bwrap/seatbelt với proxy egress L7 không khả dụng — hãy dùng Linux, macOS hoặc WSL cho các tính năng này.

    Về hạ tầng, bạn chỉ cần một máy chủ Linux ổn định và đăng nhập được bằng SSH vào VPS Linux là đủ bắt đầu. Vì hệ sinh thái Omnigent xoay quanh Python 3.12, nhiều người chọn sẵn một VPS chạy Python để đảm bảo môi trường deploy script và bot về sau cũng dùng chung một máy.

    sudo apt update && sudo apt install -y git tmux bubblewrap curl
    Yêu cầu khi cài Omnigente trên VPS
    Yêu cầu khi cài Omnigente trên VPS

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    VPS luôn online — trạm điều phối agent 24/7

    Omnigent phát huy tối đa sức mạnh khi chạy trên một host có URL ổn định, luôn trực tuyến để bạn truy cập từ điện thoại hay để cả nhóm cùng vào phiên làm việc. Một chiếc VPS Linux giá rẻ với quyền root đầy đủ là môi trường lý tưởng để cài Python 3.12, Node.js và toàn bộ công cụ mà Omnigent cần — không phải giữ laptop mở máy liên tục.

    Tham khảo VPS giá rẻ

    Hướng dẫn cài đặt Omnigent trên VPS chi tiết

    Omnigent cung cấp kịch bản cài đặt tự động giúp thiết lập toàn bộ công cụ nền tảng một cách nhanh chóng chỉ với một câu lệnh đơn giản.

    Kiểm tra hệ điều hành và Python

    Chạy lệnh:

    cat /etc/os-release
    python3 --version

    Cách 1: Sử dụng Script cài đặt Omnigent tự động (Khuyến nghị)

    Chạy lệnh sau trên terminal của VPS để tải và khởi chạy script chính thức:

    curl -fsSL https://raw.githubusercontent.com/omnigent-ai/omnigent/main/scripts/install_oss.sh | sh
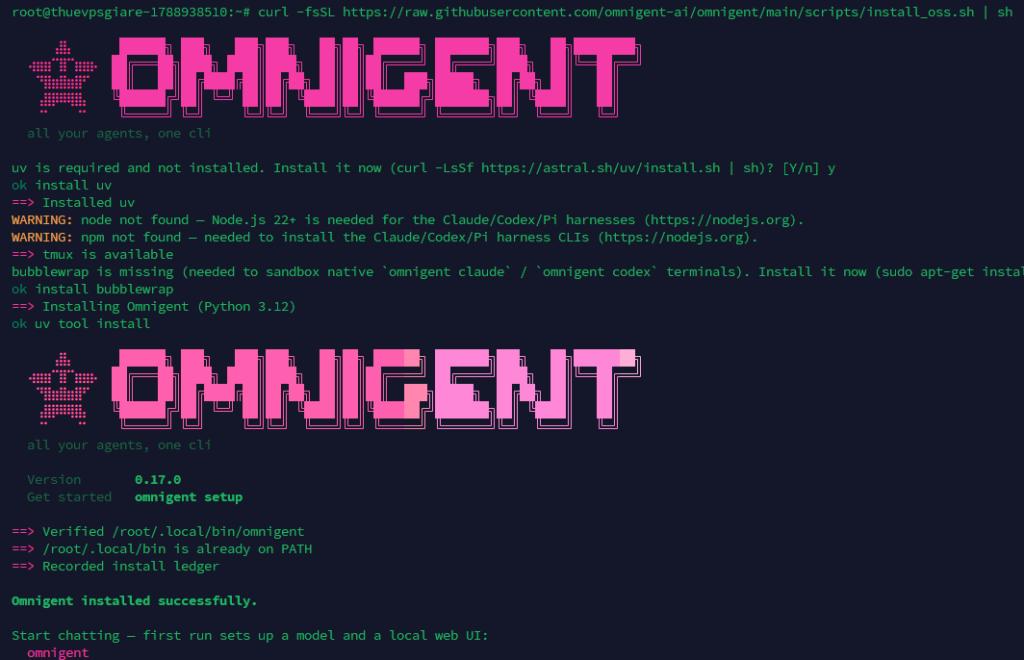
    Sử dụng Script cài đặt Omnigent tự động

    Nếu bạn cần cài đặt thêm các tiện ích mở rộng (extras) tùy chọn như kết nối sandbox (Modal, E2B) hoặc nhà cung cấp đám mây, hãy truyền tham số --extra vào kịch bản:

    curl -fsSL https://raw.githubusercontent.com/omnigent-ai/omnigent/main/scripts/install_oss.sh | sh -s -- --extra modal,e2b

    Cách 2: Cài đặt thủ công bằng uv hoặc pip

    Trong trường hợp bạn muốn kiểm soát chi tiết môi trường Python hoặc tự biên dịch từ repository, sử dụng công cụ uv:

    # Cài đặt qua uv tool
    uv tool install omnigent
    
    # Hoặc cài đặt kèm extras tùy chọn
    uv tool install "omnigent[databricks,modal]"
    
    # Cài đặt trực tiếp từ kho mã nguồn Git
    uv tool install -q --python 3.12 git+https://github.com/omnigent-ai/omnigent.git

    Sau khi hoàn tất cài đặt, hai lệnh thực thi là omnigent và omni sẽ được thêm vào biến môi trường PATH. Bạn có thể sử dụng linh hoạt cả hai tên lệnh này.

    Cập nhật và gỡ Omnigent

    Khi có bản phát hành mới trên PyPI, Omnigent hiển thị thông báo một dòng và bạn có thể cập nhật bằng:

    omni upgrade # tự nhận diện cách bạn đã cài, dừng local server rồi chạy lệnh nâng cấp tương ứng
    omni upgrade --check # chỉ báo cáo xem có bản mới không

    omni upgrade chờ các phiên agent đang chạy hoàn tất trước khi dừng local server (thêm --force để dừng ngay); lệnh omni tiếp theo sẽ đưa server trở lại trên phiên bản mới. Bản checkout từ mã nguồn thì cập nhật bằng git pull. Muốn tắt thông báo, đặt biến OMNIGENT_NO_UPDATE_CHECK=1.

    Để gỡ, trước tiên xem trước phần dọn dẹp sẽ chạy mặc định với omnigent uninstall, hoặc gỡ CLI và PATH do installer quản lý nhưng giữ lại lịch sử, credentials và dự án:

    omnigent uninstall
    omnigent uninstall --yes

    Muốn xóa cả trạng thái Omnigent trong ~/.omnigent, thêm --purge (dữ liệu được backup ra ngoài trước khi xóa); workspace ~/omnigent vẫn được giữ trừ khi bạn thêm --purge-workspace:

    omnigent uninstall --purge --yes

    Nếu wheel đã cài bị hỏng hoặc omnigent không còn trên PATH, hãy chạy script độc lập:

    curl -fsSL https://raw.githubusercontent.com/omnigent-ai/omnigent/main/scripts/uninstall_oss.sh | sh

    Khởi động agent AI đầu tiên trên Omnigent

    Lệnh omnigent sẽ cùng bạn chọn model rồi mở một phiên ngay trong terminal. Đồng thời nó khởi chạy web UI cục bộ tại http://localhost:6767 hiển thị cùng phiên đó trên trình duyệt, hoặc trên điện thoại trong cùng mạng. Ứng dụng desktop bọc chính UI này trong cửa sổ native, thêm thông báo hệ điều hành và dock badge — có bản tải về cho macOS.
    Khởi động agent AI đầu tiên trên Omnigent

    Quá trình cài đặt đặt hai tên cho cùng một CLI trên PATH: omnigent và omni ngắn gọn hơn — hai cái dùng thay thế cho nhau. Lần chạy đầu, Omnigent sẽ nhận diện credentials đã có sẵn trong môi trường (một ANTHROPIC_API_KEY/OPENAI_API_KEY, hoặc CLI claude/codex đã đăng nhập) và đề xuất một cái làm mặc định:

    omnigent

    Hoặc bạn có thể khởi động một runtime agent cụ thể:

    omnigent claude # Claude Code, trong phiên cả nhóm có thể tham gia
    omnigent codex # Codex
    omnigent cursor # Cursor
    omnigent agy # Antigravity
    omnigent opencode # OpenCode
    omnigent hermes # Hermes Agent (Nous Research)
    omnigent pi # Pi
    omnigent copilot # GitHub Copilot (SDK harness, qua `omnigent run`)

    Lưu ý omnigent agy yêu cầu agy 1.1.13 trở lên; khi biến GEMINI_API_KEY được đặt, xác thực Gemini API trực tiếp sẽ được ưu tiên hơn đăng nhập OAuth đã lưu của agy. Với OpenCode — một trong các harness được hỗ trợ — nếu bạn muốn hiểu kỹ công cụ này trên môi trường Ubuntu, có thể đọc thêm bài cài đặt OpenCode trên Ubuntu để nắm cấu hình API key nền tảng.

    Tương tự, Hermes Agent trên Ubuntu cũng đã có hướng dẫn riêng nếu bạn định chạy harness omnigent hermes lâu dài.

    Đối với các công cụ như OpenClaw, bạn có thể xem thêm hướng dẫn cài đặt OpenClaw trên Ubuntu để kết nối phiên Gateway trực tiếp qua giao thức ACP. Đối với Grok Build (xAI) và Devin (Cognition), bạn cài đặt CLI của từng hãng, đăng nhập xác thực rồi chạy lệnh omnigent run --harness grok hoặc omnigent run --harness devin.

    Grok Build và Devin: hai harness tích hợp sẵn

    Hai coding agent này được tích hợp sẵn nhưng không có launcher omnigent <name> riêng, vì mỗi cái có CLI tự quản lý đăng nhập. Bạn cài CLI của vendor, đăng nhập bằng CLI đó, rồi gọi harness:

    # Grok Build (xAI)
    curl -fsSL https://x.ai/cli/install.sh | bash
    grok login --device-auth # xAI OAuth
    omnigent run --harness grok # 'grok-build' cũng hoạt động
    # Devin (Cognition)
    curl -fsSL https://cli.devin.ai/install.sh | bash
    devin auth login
    omnigent run –harness devin

    Cả hai nói giao thức Agent Client Protocol (ACP) qua stdio, và Omnigent không lưu credential nào cho chúng — mỗi CLI tự đọc lại thông tin đăng nhập đã ghi ra đĩa. Vì vậy --model sẽ bị từ chối thay vì âm thầm bỏ qua: cả hai chạy model mặc định của tài khoản.

    Muốn chốt model, hãy cấu hình một agent acp: mà command truyền flag model của riêng vendor. Tài liệu cũng khuyến nghị dùng đăng nhập vendor thay vì API key; nếu bắt buộc dùng key, truyền tường minh bằng OMNIGENT_RUNNER_ENV_PASSTHROUGH=XAI_API_KEY hoặc khai báo passthrough trong agent acp:.

    Polly, Debby và Deep Research: các agent ví dụ

    Repo có sẵn hai agent ví dụ rất hợp cho phiên đầu tiên:

    omnigent run examples/polly/
    omnigent run examples/debby/
    omnigent run examples/deep-research/
    # …hoặc chạy trên harness khác (sub-agent vẫn giữ harness riêng):
    omnigent run examples/polly/ –harness <harness>
    omnigent run examples/debby/ –harness <harness>

    Polly là một multi-agent coding orchestrator — cô ấy không tự viết code mà đóng vai tech lead: lập kế hoạch, giao việc cho các coding sub-agent (Claude Code, Codex hoặc Pi) chạy song song trong các git worktree, rồi chuyển từng diff cho một reviewer của nhà cung cấp khác với người viết. Bạn là người merge.

    Debby là đối tác brainstorm hai “cái đầu” — một Claude và một GPT; mỗi câu hỏi của bạn được gửi cho cả hai và hai câu trả lời đặt cạnh nhau; gõ /debate để hai đầu phê bình lẫn nhau vài vòng rồi hội tụ (cô ấy cần đồng thời credential Claude và OpenAI).

    Deep Research là một agent duy nhất trả lời câu hỏi bằng báo cáo trích dẫn, đối chiếu chéo — lập kế hoạch sub-query, tìm kiếm web trực tiếp qua MCP search server và xác minh từng luận điểm trên các nguồn độc lập; đây cũng là ví dụ đơn giản nhất để sao chép.

    Chạy server cục bộ và kiểm soát trạng thái

    Nếu thích dùng trình duyệt, một lệnh khởi động server cục bộ và đăng ký máy hiện tại làm host:

    omnigent start # khởi động local server và đăng ký máy này làm host

    Mở URL server in ra, bấm New Chat, chọn máy của bạn và bắt đầu. Kiểm tra trạng thái bằng omnigent server status; dừng toàn bộ bằng omnigent stop. Muốn chặn tab trình duyệt tự mở, dùng omni host --no-open hoặc đặt OMNIGENT_HOST_NO_OPEN=1 trong shell.

    Một phiên cũng có thể tự khởi chạy: trang Automations chạy agent theo lịch định kỳ — định dạng lịch, REST API và giới hạn hiện tại nằm trong automations guide của dự án.

    Chọn và chuyển đổi model AI cho Omnigent

    Để thêm credential, đặt model mặc định hoặc gỡ bỏ — nhóm theo từng agent — chạy lệnh:

    omnigent setup

    Omnigent làm việc với bốn loại credentials:

    Loại Đặc điểm
    API key Key trực tiếp từ nhà cung cấp như Anthropic, OpenAI và tương tự
    Subscription Gói Claude Pro/Max hoặc ChatGPT, thông qua CLI chính thức claude/codex
    Gateway Bất kỳ base_url và key tương thích OpenAI/Anthropic (OpenRouter, LiteLLM, Ollama, vLLM, Azure)
    Databricks Workspace profile Databricks (cần extra databricks)

    Mặc định là theo từng agent, nên một default cho Claude và một default cho Codex có thể tồn tại song song. Trong lúc làm việc, bạn vẫn chuyển model giữa phiên bằng lệnh /model.

    Base URL cho Gateway (OpenRouter, Ollama)

    Khi thêm credential loại Gateway, omnigent setup sẽ hỏi base URL và key. Base URL phụ thuộc agent bạn trỏ tới:

    Provider Dùng cho Base URL Key
    OpenRouter Claude Code https://openrouter.ai/api OpenRouter key của bạn (sk-or-…)
    OpenRouter Codex / OpenAI agents https://openrouter.ai/api/v1 OpenRouter key của bạn (sk-or-…)
    Ollama (local) Codex / OpenAI agents http://localhost:11434/v1 Giá trị bất kỳ (Ollama bỏ qua)

    Với Claude Code, hãy trỏ tới endpoint tương thích Anthropic của OpenRouter (…/api, không phải …/api/v1). Với Codex và harness OpenAI-agents, dùng …/api/v1 tương thích OpenAI.

    Thiết lập xác thực và quản lý Model Provider

    Omnigent mang đến sự linh hoạt tối đa khi hỗ trợ 4 nhóm thông tin xác thực mô hình AI khác nhau. Để cấu hình tài khoản, hãy thực thi lệnh:

    omnigent setup
    Loại xác thực Đặc điểm chi tiết
    API Key Khóa API trực tiếp từ nhà cung cấp gốc như Anthropic (Claude), OpenAI. Tự động nhận diện nếu đã set ANTHROPIC_API_KEY hoặc OPENAI_API_KEY.
    Subscription Sử dụng gói thuê bao cá nhân (Claude Pro/Max hoặc ChatGPT Plus) thông qua việc đăng nhập sẵn trên CLI chính thức của claude hoặc codex.
    Gateway Mọi cổng tương thích với chuẩn Anthropic hoặc OpenAI API như OpenRouter, LiteLLM, Ollama hoặc vLLM cục bộ.
    Databricks Kết nối workspace hồ sơ doanh nghiệp (yêu cầu cài đặt extra databricks).

    Lưu ý cấu hình Base URL cho cổng Gateway:

    • OpenRouter dùng cho Claude Code: Điền endpoint https://openrouter.ai/api (chú ý không dùng đuôi /api/v1).
    • OpenRouter dùng cho Codex / OpenAI agents: Sử dụng endpoint https://openrouter.ai/api/v1.
    • Ollama chạy local trên máy chủ: Sử dụng endpoint http://localhost:11434/v1 (Key có thể nhập giá trị bất kỳ).

    Triển khai Omnigent Server chạy nền và làm việc nhóm

    Để biến VPS thành một trạm điều phối AI luôn luôn sẵn sàng phục vụ làm việc nhóm, bạn nên khởi chạy Omnigent dưới dạng máy chủ dịch vụ chạy nền.

    Bật chế độ xác thực đa người dùng (Multi-User)

    Kích hoạt biến môi trường xác thực và khởi chạy server chạy ngầm:

    OMNIGENT_AUTH_ENABLED=1 omnigent server --background

    Trong lần khởi động đầu tiên, hệ thống sẽ sinh ra mật khẩu cho tài khoản admin và lưu trữ cục bộ. Bạn có thể kiểm tra trạng thái bằng omnigent server status hoặc tắt dịch vụ bằng omnigent stop.

    Nếu muốn vận hành độc lập trong container, bạn có thể triển khai thông qua việc cài đặt Docker Compose trên Ubuntu để quản lý tài nguyên linh hoạt hơn.

    Mở cổng Firewall cho Web UI

    Giao diện Web UI mặc định lắng nghe trên cổng 6767. Để truy cập từ bên ngoài, bạn cần đảm bảo tường lửa đã cho phép lưu lượng truy cập. Bạn có thể xem thêm hướng dẫn mở port với tường lửa UFW và thực hiện lệnh:

    sudo ufw allow 6767/tcp
    sudo ufw reload

    Cộng tác và chia sẻ phiên làm việc

    • Mời thành viên: Truy cập Web UI dưới quyền admin, vào Admin → Members → Invite để tạo link mời dùng một lần.
    • Cùng điều khiển (Co-drive): Đồng nghiệp có thể kết nối vào phiên đang chạy của bạn bằng câu lệnh:
      omnigent attach <session_id>
    • Rẽ nhánh (Fork): Tạo một bản sao độc lập của cuộc trò chuyện để thử nghiệm hướng giải quyết khác:
      omnigent run --fork <session_id>

    Thiết lập quản trị an toàn bằng Policy và viết Custom Agent

    Một điểm mạnh nổi bật của Omnigent là cơ chế quản trị hành vi tác nhân (Policies). Hệ thống cho phép bạn chặn đứng các hành động rủi ro, giới hạn ngân sách tiêu thụ và kiểm soát việc gọi công cụ hệ thống.

    Cấu hình Policy kiểm soát an toàn

    Chính sách kiểm soát có thể khai báo tại tệp cấu hình server hoặc trực tiếp trong file cấu hình YAML của từng agent:

    policies:
      approve_shell:
        type: function
        handler: omnigent.policies.builtins.safety.ask_on_os_tools   # Hỏi ý kiến người dùng trước khi thực thi shell/ghi file
      cap_calls:
        type: function
        handler: omnigent.policies.builtins.safety.max_tool_calls_per_session
        factory_params:
          limit: 50                    # Giới hạn số lần gọi tool tối đa trong 1 session
      budget:
        type: function
        handler: omnigent.policies.builtins.cost.cost_budget
        factory_params:
          max_cost_usd: 5.00           # Giới hạn trần chi phí 5 USD cho mỗi session
          ask_thresholds_usd: [3.00]   # Cảnh báo mềm khi đạt ngưỡng 3 USD

    Tự định nghĩa Agent tùy chỉnh bằng file YAML

    Bạn có thể định nghĩa một agent độc lập chỉ với một tệp YAML cấu hình đơn giản chứa vai trò, runtime thực thi và danh mục công cụ (Python hàm nội bộ, giao thức MCP hoặc Sub-agent):

    name: my_agent
    prompt: You are a helpful data analyst.
    
    executor:
      harness: claude-sdk          # Tùy chọn: claude-native, codex, cursor, hermes, opencode, pi...
    
    tools:
      # Gọi một hàm Python nội bộ
      word_count:
        type: function
        callable: mypackage.mymodule.word_count
    
      # Kết nối công cụ từ máy chủ MCP
      docs:
        type: mcp
        url: https://example.com/mcp
    
      # Tác nhân phụ ủy quyền
      researcher:
        type: agent
        prompt: Search for relevant information and summarize it.
        tools:
          word_count: inherit

    Sau khi định nghĩa xong file my_agent.yaml, khởi chạy tác nhân bằng lệnh:

    omnigent run path/to/my_agent.yaml

    Để các tác vụ tự động chạy theo lịch biểu định kỳ mà không cần can thiệp thủ công, bạn có thể tham khảo phương pháp thiết lập Cronjob trên VPS kết hợp với giao thức API của Omnigent. Ngoài ra, việc chủ động sao lưu dữ liệu máy chủ tự động định kỳ cho thư mục ~/.omnigent cũng giúp bảo vệ toàn vẹn lịch sử phiên và khóa API quan trọng.

    Câu hỏi thường gặp khi cài Omnigent trên VPS

    Omnigent có mất phí không?

    Omnigent là dự án mã nguồn mở công khai trên GitHub, bản thân phần mềm không thu phí. Chi phí thực tế của bạn nằm ở phần model (API key, subscription hay gateway) và hạ tầng VPS/cloud sandbox chạy agent.

    VPS cần đáp ứng yêu cầu gì tối thiểu?

    Theo tài liệu chính thức, yêu cầu cứng là Python 3.12+, kèm uv, git, Node.js 22 LTS với npm/pnpm, tmux và bubblewrap trên Linux. Bạn nên chọn hệ điều hành phổ biến như Ubuntu để mọi lệnh trong bài chạy đúng, đồng thời cân đối RAM/CPU đủ cho số agent chạy song song theo nhu cầu thực tế của mình.

    Làm sao cập nhật Omnigent lên phiên bản mới?

    Chạy omni upgrade — lệnh này tự nhận diện cách bạn đã cài, chờ các phiên agent đang chạy xong rồi dừng local server và nâng cấp. Muốn chỉ kiểm tra, dùng omni upgrade --check. Bản cài từ mã nguồn thì cập nhật bằng git pull.

    Omnigent chạy tốt trên Windows không?

    Chạy được nhưng ở chế độ “degraded”: omnigent server, web UI và các harness SDK hoạt động bình thường, còn terminal wrapper native (tmux/PTY) và sandbox bwrap/seatbelt không khả dụng. Với trải nghiệm đầy đủ — nhất là khi chạy server cho nhóm — hãy dùng Linux, macOS hoặc WSL.

    Tôi có thể chạy nhiều agent của nhiều nhà cung cấp trong một phiên?

    Có. Đây chính là điểm mạnh của meta-harness: bạn trộn Claude Code, Codex, Cursor, OpenCode, Hermes, Pi và agent tùy chỉnh bằng YAML trong cùng một phiên, nhờ một agent review công việc của agent khác, hoặc chia task cho agent giỏi từng mảng riêng.

    Quy trình cài đặt Omnigent trên VPS về bản chất chỉ gồm ba trụ cột: chuẩn bị đủ Python 3.12+, Node.js 22 LTS, uv, git, tmux và bubblewrap; chạy lệnh cài chính thức rồi khởi động agent đầu tiên bằng omnigent hoặc omnigent start; và khi muốn cả nhóm cùng dùng, triển khai server bằng docker compose up rồi đăng ký máy làm host với omnigent host. Đừng quên cấu hình credentials qua omnigent setup để chọn model phù hợp, và tận dụng policies để kiểm soát hành vi agent ngay từ đầu.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung bài viết mang tính chất hướng dẫn kỹ thuật tham khảo. Các câu lệnh, tham số cài đặt và giao diện phần mềm có thể thay đổi tùy theo các bản phát hành mới của Omnigent cũng như môi trường hệ điều hành thực tế. Bạn nên kiểm thử trong môi trường an toàn trước khi áp dụng chính thức cho các dự án quan trọng.
  • Cách Setup Directus Headless CMS Trên VPS, API Cực Mượt Cho App

    Cách Setup Directus Headless CMS Trên VPS, API Cực Mượt Cho App

    Triển khai Headless CMS siêu tốc Directus trên VPS là lời giải cho bài toán đồng bộ nội dung thời gian thực trên cả một hệ sinh thái ứng dụng di động. Thay vì dựng từng hệ quản trị rời rạc cho mỗi app, bạn chỉ cần một chiếc VPS cấu hình vừa sức cùng Docker Compose là có ngay trung tâm dữ liệu phục vụ đồng thời iOS lẫn Android. Trong bài, chúng tôi cũng gợi ý luôn phương án thuê máy chủ tại ThueVPSGiaRe.vn để bạn triển khai được ngay sau khi đọc xong.

    Vì sao chuỗi ứng dụng di động trở thành bài toán khó của quản trị nội dung?

    Nội dung rời rạc, cập nhật thủ công từng app một và chất lượng API yếu kém là ba điểm nghẽn lớn nhất khi doanh nghiệp phải nuôi nhiều ứng dụng di động cùng lúc. Đây chính là lúc kiến trúc Headless CMS như Directus thể hiện giá trị của mình, và phần dưới đây sẽ phân tích cụ thể từng vấn đề.

    Ở giai đoạn chuyển đổi số sâu rộng như hiện nay, nhiều doanh nghiệp vừa và lớn đã không còn dừng lại ở một ứng dụng duy nhất mà vận hành cả một hệ sinh thái mobile app chuyên biệt. Ví dụ điển hình là một tập đoàn bán lẻ có thể cùng lúc duy trì app mua sắm, app dành cho khách hàng thân thiết (loyalty) và app nội bộ phục vụ đội ngũ giao vận.

    Khi đó, câu hỏi gây đau đầu nhất cho bộ phận vận hành là: làm thế nào để nội dung trên toàn bộ các app này luôn nhất quán, cập nhật theo thời gian thực (real-time) mà không khiến đội kỹ thuật phải gồng mình duy trì hàng loạt hệ thống rời rạc?

    Nếu vẫn giữ tư duy CMS truyền thống (Traditional CMS), doanh nghiệp buộc phải dựng một hệ quản trị riêng cho từng ứng dụng, hoặc xiết chặt bản thân để tùy biến những monolithic CMS kiểu WordPress. Cái giá phải trả khá đắt:

    • Dữ liệu bị chia năm xẻ bảy: Mỗi app một kho dữ liệu riêng, rất khó bảo đảm tính nhất quán trên toàn hệ sinh thái.
    • Chất lượng API yếu kém: App di động nhận dữ liệu chậm, trải nghiệm người dùng cuối chịu ảnh hưởng trực tiếp.
    • Chi phí bảo trì đội lên theo cấp số nhân: Mỗi lần thêm một app mới, gánh nặng vận hành lại nhân lên nhiều lần.

    Kiến trúc Headless CMS ra đời để chấm dứt tình trạng trên bằng cách tách hẳn tầng quản trị dữ liệu (Backend) khỏi tầng hiển thị (Frontend/App UI). Trong số các phương án Headless CMS hiện có, Directus được xem là cái tên sáng giá bậc nhất nhờ ba thế mạnh: kết nối thẳng vào cơ sở dữ liệu đang có, hiệu năng ấn tượng và mức độ linh hoạt gần như không giới hạn.

    Nội dung tiếp theo sẽ dẫn bạn đi hết quy trình dựng nhanh Directus trên máy chủ ảo (VPS) để làm trung tâm nội dung cho chuỗi app đa nền tảng (Flutter, React Native, Native iOS/Android).

    Directus nổi bật ở điểm nào so với các Headless CMS khác?

    Điều khiến Directus khác biệt so với các Headless CMS phổ biến (như Strapi hay Contentful) là nó đóng vai trò như một lớp phủ dữ liệu thông minh (Database Wrapper) nằm ngay trên database sẵn có của bạn, thay vì bắt bạn theo mô hình dữ liệu do nhà phát triển quy định.

    Điểm nổi bật của Directus so với Headless CMS khác

    Dưới đây là bốn lý do cốt lõi khiến Directus trở thành lựa chọn tối ưu cho hệ sinh thái nhiều ứng dụng di động:

    • Không bị khóa dữ liệu (No Data Lock-in): Directus phản chiếu (mirror) trực tiếp database SQL mà bạn đang dùng — PostgreSQL, MySQL hay SQLite — thay vì ép bạn nạp lại dữ liệu theo cấu trúc của nó. Nói cách khác, tài sản dữ liệu vẫn thuộc hoàn toàn về doanh nghiệp.
    • API REST và GraphQL sinh tự động (Auto-generated APIs): Bạn vừa tạo một Collection (bảng dữ liệu), Directus lập tức mở kèm hệ thống API chuẩn RESTful và GraphQL được tối ưu, đầy đủ tài liệu tra cứu trực quan. Dev mobile chỉ việc gọi và dùng ngay — ai còn mơ hồ về cơ chế này có thể đọc qua bài giải thích khái niệm API cho người mới để nắm nền tảng trước khi thực hành.
    • Phân quyền (RBAC) chi tiết đến từng chi tiết: Với một chuỗi ứng dụng, phân quyền là chuyện sống còn. Directus cho phép cấu hình quyền theo từng trường dữ liệu (field-level) và từng hành động (Create, Read, Update, Delete), rất thuận tiện khi nhiều nhóm nhân sự cùng khai thác một hệ thống.
    • Media tập trung và tự động tối ưu: Bộ quản lý file tích hợp sẵn hỗ trợ thay đổi kích thước hình ảnh (Image Transformation) ngay thông qua URL, giúp ứng dụng di động tải nhẹ hơn, tiết kiệm băng thông và cải thiện tốc độ hiển thị.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ Tầng VPS Tốc Độ Cao Cho API Mobile Chạy Mượt Mà

    Hệ thống Directus API yêu cầu phản hồi mili-giây để đảm bảo trải nghiệm người dùng mobile không bị gián đoạn. Dịch vụ máy chủ ảo tại Fast Byte cung cấp ổ cứng SSD NVMe tốc độ đọc ghi cao, băng thông rộng trong nước cùng tài nguyên độc lập giúp backend của bạn luôn sẵn sàng chịu tải.

    Tham khảo VPS giá rẻ

    3. Kiến trúc tổng thể của hệ thống VPS, Directus Engine và Mobile Clients

    Để đưa hệ thống vào vận hành thực tế cho nhiều ứng dụng cùng kết nối, kiến trúc hạ tầng cần bảo đảm tính mở rộng linh hoạt, độ an toàn và việc quản lý tài nguyên khép kín. Giải pháp tiêu chuẩn gồm mô hình 3 lớp phân tách rõ rệt:

    Database Layer (PostgreSQL) <-> Core Engine Layer (Directus Node.js) <-> Reverse Proxy (Nginx + SSL) <-> Mobile Clients (REST/GraphQL)

    Phương pháp triển khai Directus container hóa trên VPS mang lại nhiều lợi thế:

    • Độc lập môi trường: Đóng gói các thành phần phần mềm vào container giúp việc sao lưu dữ liệu, migrate máy chủ hoặc nhân bản từ môi trường thử nghiệm sang production diễn ra nhanh gọn chỉ trong vài phút.
    • Bảo vệ cơ sở dữ liệu: Hệ quản trị cơ sở dữ liệu PostgreSQL nằm hoàn toàn trong mạng nội bộ của Docker (private network), không mở cổng ra ngoài Internet, ngăn ngừa nguy cơ bị quét cổng hay tấn công trực diện.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Cấu hình nào đủ sức cho Directus và PostgreSQL chạy song song?

    Theo khuyến nghị của quy trình triển khai bên dưới, bạn chỉ cần VPS tối thiểu 2 Cores CPU, 4GB RAM chạy Ubuntu 22.04 LTS là hai container Directus (Node.js) và PostgreSQL đã vận hành êm ái ngay từ đầu. Với VPS giá rẻ của Fast Byte, bạn toàn quyền cài Docker, tự quản trị hệ thống và nâng tài nguyên lên bất cứ lúc nào khi lượng người dùng tăng.

    Tham khảo VPS giá rẻ

    4. Hướng dẫn triển khai Directus trên VPS bằng Docker Compose qua 3 bước

    Trước khi bắt đầu triển khai Directus trên VPS bằng Docker Compose, bạn cần chuẩn bị một máy chủ VPS sạch với cấu hình khuyến nghị tối thiểu 2 CPU Cores, 4GB RAM và cài đặt hệ điều hành Ubuntu 22.04 LTS.

    triển khai Directus trên VPS

    Sau đây là quy trình 3 bước triển khai nhanh chóng.

    Bước 1: Chuẩn bị môi trường máy chủ VPS

    Đăng nhập SSH vào máy chủ với quyền quản trị root, cập nhật danh sách gói phần mềm và tiến hành cài đặt Docker Engine trên Ubuntu cùng tiện ích mở rộng bằng chuỗi lệnh:

    sudo apt update && sudo apt upgrade -y
    sudo apt install docker.io docker-compose -y
    sudo systemctl enable --now docker

    Để quản lý nhiều container dễ dàng hơn, bạn cũng có thể tham khảo thêm hướng dẫn thiết lập công cụ Docker Compose để làm quen với các thao tác quản lý vòng đời ứng dụng.

    Bước 2: Soạn thảo file cấu hình docker-compose.yml

    Tạo thư mục làm việc riêng cho hệ thống và mở trình soạn thảo để khai báo tệp cấu hình triển khai:

    mkdir directus-cms && cd directus-cms
    nano docker-compose.yml

    Dán đoạn mã cấu hình chuẩn hóa sau vào tệp. Hãy lưu ý thay thế các mật khẩu mặc định thành chuỗi bí mật an toàn:

    version: '3'
    services:
      database:
        image: postgres:15
        container_name: directus-db
        restart: always
        volumes:
          - pgdata:/var/lib/postgresql/data
        environment:
          POSTGRES_USER: directus_user
          POSTGRES_PASSWORD: SecurePassword123
          POSTGRES_DB: directus_prod
    
      directus:
        image: directus/directus:latest
        container_name: directus-core
        restart: always
        ports:
          - "8055:8055"
        volumes:
          - ./uploads:/directus/uploads
          - ./extensions:/directus/extensions
        environment:
          KEY: "random-string-for-security-key"
          SECRET: "random-string-for-security-secret"
          DB_CLIENT: "pg"
          DB_HOST: "database"
          DB_PORT: "5432"
          DB_DATABASE: "directus_prod"
          DB_USER: "directus_user"
          DB_PASSWORD: "SecurePassword123"
          ADMIN_EMAIL: "[email protected]"
          ADMIN_PASSWORD: "AdminSecurePass2026"
          CORS_ENABLED: "true"
          CORS_ORIGIN: "*"
        depends_on:
          - database
    
    volumes:
      pgdata:

    File trên khai báo hai service: database (PostgreSQL 15) và directus (lõi CMS chạy ở cổng 8055), trong đó đã nêu sẵn các biến môi trường từ thông tin kết nối database, tài khoản admin cho đến thiết lập CORS. Nếu bạn muốn hiểu rõ ý nghĩa từng khối trong file, bài hướng dẫn Docker Compose trên Ubuntu từ A đến Z sẽ giúp bạn đọc hiểu cấu trúc một cách hệ thống.

    Bước 3: Khởi chạy cụm dịch vụ và thiết lập Reverse Proxy

    Khởi động cụm dịch vụ Directus và cơ sở dữ liệu PostgreSQL ở chế độ chạy ngầm (detached mode):

    docker-compose up -d

    Hệ thống sẽ tự động khởi tạo cấu trúc cơ sở dữ liệu ban đầu. Lúc này, bạn có thể kiểm tra cổng 8055 bằng địa chỉ IP của VPS. Để đưa vào sử dụng thực tế cho ứng dụng mobile kết nối, hãy thực hiện trỏ tên miền về máy chủ VPS (ví dụ: api-cms.business.com). Tiếp theo, bạn thực hiện cấu hình máy chủ web Nginx làm reverse proxy và kích hoạt chứng chỉ SSL Let’s Encrypt qua Certbot để toàn bộ luồng truyền tin API được mã hóa an toàn qua giao thức HTTPS.

    DANH MỤC KIỂM TRA TRƯỚC KHI ĐƯA HỆ THỐNG VÀO DÙNG THẬT

    • ✅ Thay KEY và SECRET bằng chuỗi ngẫu nhiên riêng của bạn, tuyệt đối không giữ giá trị mẫu.
    • ✅ Cập nhật ADMIN_EMAIL và ADMIN_PASSWORD thành tài khoản quản trị thực tế của doanh nghiệp.
    • ✅ Đổi POSTGRES_PASSWORD và DB_PASSWORD khớp nhau, tránh dùng mật khẩu ví dụ.
    • ✅ Thu hẹp CORS_ORIGIN theo đúng domain các ứng dụng thay vì mở * cho tất cả.

    5. Tổ chức dữ liệu cho nhiều ứng dụng mobile ra sao cho gọn?

    Sau khi đăng nhập vào giao diện Admin trực quan của Directus, việc tiếp theo là thiết kế các Collections (bảng dữ liệu) sao cho chúng phục vụ hiệu quả cho nhiều ứng dụng cùng lúc. Một chiến lược tổ chức dữ liệu thông minh xoay quanh hai hướng tiếp cận sau:

    A. Gom nội dung dùng chung vào Shared Collections

    Những nội dung mà mọi app trong chuỗi đều cần truy cập — chẳng hạn thông tin doanh nghiệp, chính sách bảo mật, điều khoản dịch vụ hay danh mục sản phẩm cốt lõi — nên được gom vào một nhóm chung. Nhờ vậy, mỗi khi có thay đổi từ phía pháp lý hoặc nhận diện thương hiệu, người quản trị chỉ cần sửa một nơi duy nhất là toàn bộ hệ sinh thái tự động cập nhật theo.

    B. Phân tách nội dung riêng theo định danh từng ứng dụng (App-specific Filtering)

    Ngược lại, với những nội dung chỉ tồn tại ở một app nhất định (ví dụ banner khuyến mãi của App A khác hẳn banner App B), cách làm gọn gàng là bổ sung một trường dữ liệu tên app_context (dạng Dropdown hoặc quan hệ M2M trỏ về bảng danh sách app). Khi ứng dụng mobile gọi API, họ chỉ cần kèm tham số lọc (filter):

    GET /items/banners?filter[app_context][_eq]=app_loyalty

    Cơ chế này vừa giúp giảm số lượng bảng phải quản lý, vừa phát huy trọn sức mạnh truy vấn tối ưu mà Directus mang lại. Bạn có thể đối chiếu nhanh hai hướng tiếp cận qua bảng dưới đây:

    Loại nội dung Cách bố trí Lợi ích
    Thông tin doanh nghiệp, chính sách bảo mật, điều khoản, danh mục sản phẩm cốt lõi Shared Collections Sửa một lần, mọi app trong chuỗi dùng chung
    Banner khuyến mãi, nội dung riêng theo từng app Collection chung + trường app_context Lọc ngay trên API theo định danh ứng dụng, không cần tách nhiều bảng

    6. Các giải pháp tối ưu hiệu năng Directus cho môi trường Production chịu tải cao

    Khi chuỗi ứng dụng di động cán mốc hàng trăm nghìn người dùng hoạt động đồng thời (CCU lớn), bất kỳ sự chậm trễ nào từ phía CMS API cũng có thể làm gián đoạn trải nghiệm người dùng cuối. Bạn cần áp dụng đồng bộ các giải pháp tối ưu hóa hiệu năng sau:

    Giải pháp tối ưu Cơ chế hoạt động Lợi ích cho Mobile Apps
    Kích hoạt bộ nhớ đệm (Caching) Bật CACHE_ENABLED="true", phối hợp cùng cơ chế caching bằng Redis để lưu tạm kết quả truy vấn. Giảm tải tới 90% các truy vấn lặp lại vào Database, trả dữ liệu tức thì cho client.
    Chuyển file sang Cloud Storage Tích hợp driver Directus tới các dịch vụ như AWS S3 hoặc kho lưu trữ Object Storage đám mây. Giải phóng băng thông VPS, tránh nguy cơ đầy dung lượng ổ đĩa máy chủ nội bộ.
    Chắt lọc trường trả về (Fields Selection) Sử dụng tham số ?fields=id,title,thumbnail thay vì gọi toàn bộ bảng (*). Cắt giảm dung lượng gói JSON truyền tải, giúp ứng dụng parse dữ liệu nhanh và tiết kiệm RAM di động.

    7. Câu hỏi thường gặp khi triển khai Directus trên VPS (FAQ)

    Dưới đây là một số giải đáp nhanh cho các thắc mắc kỹ thuật phổ biến trong quá trình cấu hình và vận hành hệ thống Directus:

    Directus có miễn phí cho mục đích thương mại không?

    Directus là nền tảng mã nguồn mở (Open Source) và hoàn toàn miễn phí khi tự host trên hạ tầng máy chủ riêng của bạn. Phiên bản cộng đồng cung cấp đầy đủ các tính năng mạnh mẽ về API, giao diện bảng điều khiển, xác thực người dùng và quản lý dữ liệu.

    Cấu hình VPS nào là phù hợp để chạy Directus mượt mà?

    Đối với môi trường phát triển (Dev/Staging), cấu hình tối thiểu 2 vCPU và 2GB RAM là có thể hoạt động. Tuy nhiên, đối với môi trường Production phục vụ đồng thời chuỗi ứng dụng di động, bạn nên lựa chọn cấu hình từ 2 đến 4 vCPU cùng 4GB RAM trở lên kết hợp ổ cứng SSD NVMe để đảm bảo tốc độ phản hồi API luôn ổn định.

    Có thể kết nối Directus vào cơ sở dữ liệu đã có sẵn không?

    Hoàn toàn được. Đây chính là điểm mạnh vượt trội nhất của Directus. Bạn chỉ cần trỏ cấu hình kết nối tới cơ sở dữ liệu PostgreSQL hoặc MySQL sẵn có của dự án, Directus sẽ lập tức nhận diện các bảng và sinh API mà không làm thay đổi hay phá vỡ cấu trúc dữ liệu cũ.

    Quy trình triển khai Headless CMS Directus trên VPS là nước đi chiến lược giúp doanh nghiệp tiết kiệm chi phí bản quyền, làm chủ hoàn toàn dữ liệu và tối ưu hiệu suất cho chuỗi ứng dụng di động. Khi tách rời tầng hiển thị khỏi tầng lưu trữ và tận dụng sức mạnh sinh API tự động của Directus, đội ngũ phát triển có thể tập trung tối đa nguồn lực vào việc hoàn thiện trải nghiệm người dùng mobile. Hãy lựa chọn một cấu hình VPS đủ mạnh để bắt đầu thiết lập hệ thống quản trị nội dung của bạn ngay hôm nay.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung bài viết chỉ mang tính tham khảo về mặt kỹ thuật. Các lệnh, cấu hình và thông số có thể thay đổi theo hệ điều hành, phiên bản Directus, Docker Compose và môi trường thực tế của từng doanh nghiệp. Trước khi áp dụng cho môi trường production, người đọc nên kiểm thử trên staging, sao lưu đầy đủ dữ liệu và tự đánh giá rủi ro liên quan đến bảo mật cũng như hiệu năng của hệ thống.

  • Tự Host Penpot Trên VPS Ubuntu Qua Docker: Thay Thế Figma Hoàn Hảo

    Tự Host Penpot Trên VPS Ubuntu Qua Docker: Thay Thế Figma Hoàn Hảo

    Tự Host Penpot trên VPS Ubuntu đang trở thành giải pháp hàng đầu giúp các nhóm thiết kế giải quyết triệt để bài toán chi phí bản quyền đắt đỏ từ Figma cùng nguy cơ rò rỉ dữ liệu đồ họa quan trọng trên đám mây công cộng. Thay vì phụ thuộc vào các dịch vụ phần mềm đóng, việc chủ động dựng máy chủ thiết kế nội bộ với hạ tầng tại ThueVPSGiaRe.vn sẽ mang đến môi trường cộng tác UI/UX mạnh mẽ, chuẩn mở và bảo mật tuyệt đối cho doanh nghiệp.

    1. Vì Sao Doanh Nghiệp Nên Lựa Chọn Penpot Thay Vì Figma?

    Penpot là nền tảng thiết kế UI/UX mã nguồn mở đầu tiên hoạt động hoàn toàn trên nền web, sử dụng định dạng SVG làm chuẩn gốc. Khi tự host trên VPS riêng, doanh nghiệp vừa tái hiện trọn vẹn trải nghiệm cộng tác thời gian thực của Figma, vừa kiểm soát tuyệt đối dữ liệu nội bộ và không phải trả phí bản quyền theo từng người dùng.

    Lựa Chọn Penpot Thay Vì Figma

    Việc dịch chuyển từ công cụ thương mại độc quyền sang nền tảng mã nguồn mở mang lại bước ngoặt lớn về quyền kiểm soát hạ tầng và tài chính. Penpot mang đến trải nghiệm cộng tác thời gian thực chuẩn mực của một ứng dụng thiết kế hiện đại nhưng giải phóng nhóm làm việc khỏi các ràng buộc khắt khe từ bên thứ ba.

      • Bảo mật và toàn quyền kiểm soát dữ liệu: Toàn bộ source file, bản mẫu giao diện và thông số kỹ thuật được lưu giữ trên chính máy chủ ảo của công ty, loại trừ hoàn toàn nguy cơ rò rỉ bí mật công nghệ hoặc rủi ro thay đổi chính sách từ nhà cung cấp SaaS.
      • Tiết kiệm ngân sách phần mềm đáng kể: Thay vì phải chi trả chi phí thuê bao tăng dần theo từng tài khoản thành viên hàng tháng, doanh nghiệp chỉ cần duy trì chi phí cố định cho máy chủ, giúp quy mô nhân sự thiết kế tăng lên không kéo theo gánh nặng tài chính.
      • Định dạng chuẩn SVG thân thiện lập trình: Penpot sử dụng SVG làm nền tảng hiển thị gốc. Nhờ đó, các thuộc tính CSS, bố cục Flexbox và Grid được thể hiện chân thực, hỗ trợ lập trình viên bóc tách mã nguồn nhanh chóng mà không gặp xung đột định dạng.
      • Khả năng tùy chỉnh và mở rộng qua API: Do sở hữu mã nguồn mở, đội ngũ kỹ thuật có thể tích hợp sâu Penpot vào quy trình phát triển sản phẩm, hệ thống CI/CD hoặc các cổng thông tin nội bộ của công ty.

    2. Cấu Hình Phần Cứng Khuyến Nghị Khi Triển Khai Penpot Trên VPS

    Penpot bao gồm nhiều microservices xử lý đồ họa vector, cơ sở dữ liệu PostgreSQL và dịch vụ xử lý backend bằng Elixir/Clojure nên việc lựa chọn cấu hình máy chủ phù hợp là tiêu chuẩn tiên quyết để tránh độ trễ khi có nhiều nhân sự thao tác đồng thời.

    Để đảm bảo hiệu năng cộng tác mượt mà và không gặp tình trạng giật lag khi xử lý các file thiết kế lớn, bạn cần chuẩn bị cấu hình VPS đạt chuẩn ngay từ đầu.

    Bảng cấu hình khuyến nghị tham khảo trước khi tự host Penpot cho team thiết kế UI/UX trên VPS:

    Thông số tài nguyên Cấu hình tối thiểu (1-3 người) Cấu hình khuyến nghị (5-10 người)
    Hệ điều hành Ubuntu 22.04 LTS / 24.04 LTS Ubuntu 22.04 LTS / 24.04 LTS 64-bit
    Vi xử lý (vCPU) 2 vCPU Core 4 vCPU Core trở lên
    Bộ nhớ trong (RAM) 4GB RAM Lựa chọn các gói VPS 8GB RAM để đảm bảo độ mượt mà
    Ổ đĩa lưu trữ Tối thiểu 20GB SSD Từ 40GB – 80GB chuẩn SSD NVMe tốc độ cao
    Nền tảng phụ trợ Docker & Docker Compose Docker Engine v20+ & Docker Compose v2+

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ Tầng Tối Ưu Cho Triển Khai Container & Docker

    Dịch vụ VPS tại Fast Byte mang đến môi trường ảo hóa KVM ổn định, toàn quyền root với đường truyền mạng nội địa tốc độ cao, hỗ trợ chạy mượt mà các ứng dụng tự host như Penpot mà không lo nghẽn tài nguyên.

    Tham khảo VPS giá rẻ

    3. Hướng Dẫn Từng Bước Tự Host Penpot Bằng Docker Compose

    Việc dựng hệ thống qua Docker Compose giúp rút ngắn thời gian thiết lập hạ tầng, đóng gói mọi thư viện độc lập và hạn chế tối đa xung đột phần mềm trên môi trường máy chủ Linux.

    Bước 1: Cập nhật hệ thống và chuẩn bị Docker

    Trước hết, hãy tiến hành đăng nhập SSH vào máy chủ Linux với quyền quản trị viên, sau đó đồng bộ kho ứng dụng và nâng cấp các gói hiện có bằng lệnh:

    sudo apt update && sudo apt upgrade -y

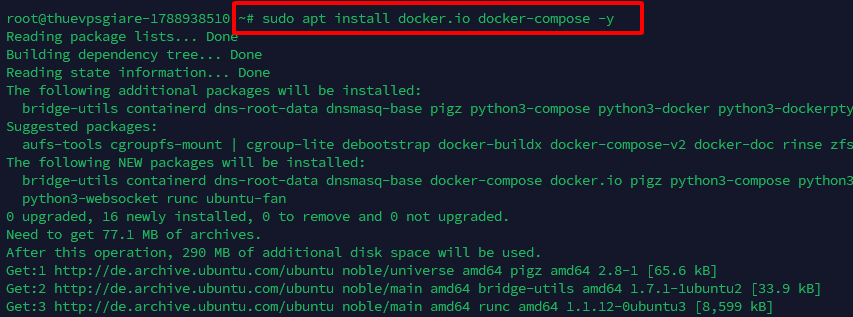
    Tiếp tục cài đặt bộ công cụ Docker Engine và tiện ích hỗ trợ Docker Compose trên nền tảng Ubuntu để phục vụ việc điều phối container:

    sudo apt install docker.io docker-compose -y
    cài đặt bộ công cụ Docker Engine
    Cài đặt bộ công cụ Docker Engine

    Bước 2: Lấy tệp cấu hình triển khai của Penpot

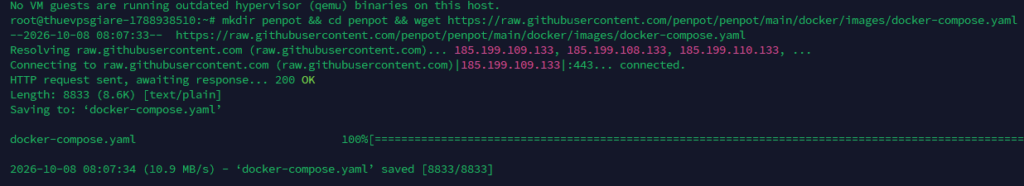
    Tạo riêng một thư mục làm việc để quản lý tệp tin và volume dữ liệu của ứng dụng, sau đó tải mẫu tệp cấu hình chuẩn được đội ngũ phát triển Penpot công bố chính thức:

    mkdir penpot && cd penpot
    wget https://raw.githubusercontent.com/penpot/penpot/main/docker/images/docker-compose.yaml
    Lấy tệp cấu hình triển khai của Penpot
    Lấy tệp cấu hình triển khai của Penpot

    Bước 3: Thiết lập các biến môi trường quan trọng

    Mở tệp tin vừa tải về bằng trình soạn thảo Nano để điều chỉnh lại các tham số bảo mật và định tuyến đường dẫn:

    nano docker-compose.yaml

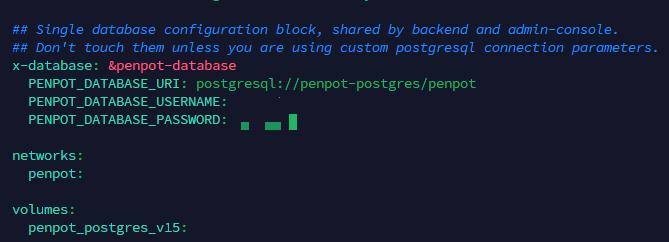
    Bên trong cấu hình, bạn cần đặc biệt lưu ý kiểm tra và tùy chỉnh các trường thông tin sau:

        • PENPOT_PUBLIC_URI: Khai báo tên miền trỏ về hệ thống Penpot (ví dụ: https://penpot.company.com).
        • PENPOT_DATABASE_PASSWORD: Thay đổi mật khẩu mặc định của cơ sở dữ liệu nội bộ PostgreSQL để chống xâm nhập trái phép.
        • Thông số SMTP (PENPOT_SMTP_DEFAULT_FROM, PENPOT_SMTP_HOST,…): Cần thiết lập chính xác để gửi email kích hoạt tài khoản nhân sự và thư mời dự án.
    Thiết lập các biến môi trường quan trọng
    Thiết lập các biến môi trường quan trọng

    Bước 4: Kích hoạt ứng dụng và tạo tài khoản quản trị Admin

    Sau khi lưu lại các sửa đổi, tiến hành kéo image và khởi chạy toàn bộ các dịch vụ chạy ngầm trong hệ thống:

    sudo docker-compose up -d

    Khi tất cả các container chuyển sang trạng thái hoạt động (running), bạn thực thi câu lệnh sau để trực tiếp tạo người dùng đầu tiên với đặc quyền quản trị:

    sudo docker-compose exec penpot-backend bin/manage create-profile

    Trình quản lý sẽ yêu cầu bạn cung cấp địa chỉ Email cùng mật khẩu bảo vệ. Sau khi hoàn thành, hồ sơ quản trị đã sẵn sàng đăng nhập trên giao diện web.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Sẵn sàng dựng Penpot cho Design Team của bạn?

    Penpot cần tối thiểu 2 vCPU, 4GB RAM và ổ SSD/NVMe để xử lý mượt các file thiết kế lớn. Một chiếc VPS riêng tại Fast Byte cho bạn toàn quyền cài đặt Docker, cấu hình SSL và nâng cấp tài nguyên bất cứ lúc nào khi đội ngũ mở rộng, thay vì bị bó buộc trong gói dịch vụ cứng.

    Tham khảo VPS giá rẻ

    4. Cấu Hình Nginx Reverse Proxy Và Kích Hoạt SSL Bảo Mật

    Giao diện frontend của Penpot mặc định lắng nghe kết nối tại cổng 9001. Để người dùng trong team truy cập qua cổng tiêu chuẩn 80/443 cùng tên miền riêng với chứng chỉ HTTPS mã hóa, việc cấu hình phần mềm máy chủ Nginx đóng vai trò Web Server chuyển tiếp là điều bắt buộc.

        1. Cài đặt dịch vụ Nginx: Thực hiện cài đặt gói web server trực tiếp từ kho apt của hệ thống:
          sudo apt install nginx -y
        2. Tạo khối Virtual Host chuyển tiếp: Tạo tệp cấu hình Nginx trỏ các truy vấn của tên miền về cổng 9001 (cổng tiếp nhận của Penpot frontend).
        3. Cấp phát chứng chỉ bảo mật HTTPS: Dễ dàng cài đặt và tự động gia hạn với chứng chỉ SSL Let’s Encrypt bằng Certbot thông qua lệnh:
          sudo apt install certbot python3-certbot-nginx -y && sudo certbot --nginx

    Chi tiết từng dòng lệnh và cách xử lý lỗi thường gặp đã được hướng dẫn đầy đủ trong bài cài chứng chỉ SSL Let’s Encrypt bằng Certbot trên VPS Ubuntu. 

    Khi quy trình chứng thực SSL kết thúc, đường truyền giữa trình duyệt của các chuyên viên thiết kế và máy chủ VPS đã được bảo vệ hoàn toàn qua giao thức an toàn HTTPS.

    5. Kinh Nghiệm Vận Hành, Tối Ưu Và Cập Nhật Penpot Định Kỳ

    Vận hành một hệ thống self-hosted ổn định cho cả một bộ phận đòi hỏi quản trị viên phải duy trì các hoạt động bảo trì định kỳ nhằm hạn chế sự cố gián đoạn trong giờ làm việc.

        • Chiến lược sao lưu dự phòng (Backup): Hãy luôn thiết lập lịch trình sao lưu dữ liệu VPS định kỳ, trong đó đặc biệt ưu tiên volume chứa cơ sở dữ liệu Postgres và thư mục assets lưu hình ảnh để tránh rủi ro hỏng hóc phần cứng.
        • Giám sát và giải phóng dung lượng đĩa: Thiết kế UI/UX sử dụng nhiều tài nguyên đồ họa dung lượng lớn. Bạn nên thường xuyên kiểm tra dung lượng còn trống trên ổ đĩa và áp dụng các thao tác dọn dẹp dữ liệu Docker thừa để loại bỏ image cũ hoặc container tạm không còn dùng đến.
        • Nâng cấp các bản phát hành mới: Penpot thường xuyên bổ sung tính năng và bản vá. Khi muốn nâng cấp, bạn chỉ cần di chuyển vào thư mục chứa dự án và chạy cặp lệnh cập nhật nhanh:
          docker-compose pull && docker-compose up -d

    6. Giải Đáp Câu Hỏi Thường Gặp Về Penpot Self-Hosted (FAQ)

    Penpot có hỗ trợ nhập trực tiếp file thiết kế từ Figma không?

    Có. Penpot hỗ trợ xuất và nhập file tiêu chuẩn SVG, đồng thời cộng đồng mã nguồn mở hiện phát triển các tiện ích mở rộng (Figma plugin) cho phép chuyển giao bố cục và thành phần từ Figma sang Penpot một cách nhanh chóng.

    Hệ thống Penpot tự host có giới hạn số lượng tài khoản thành viên không?

    Hoàn toàn không. Khác với mô hình tính phí theo số lượng người dùng (per-seat) của Figma, phiên bản tự host cho phép tạo không giới hạn tài khoản. Giới hạn duy nhất nằm ở năng lực xử lý phần cứng CPU và RAM của gói máy chủ VPS bạn sử dụng.

    Nếu không cấu hình SMTP thì Penpot có hoạt động được không?

    Hệ thống vẫn có thể khởi động bình thường. Tuy nhiên, nếu thiếu máy chủ gửi mail SMTP, các thành viên mới sẽ không thể nhận email xác thực kích hoạt tài khoản hoặc thư mời vào không gian làm việc (workspace), do đó quản trị viên cần cấu hình SMTP để quy trình vận hành trơn tru.

    Quy trình Tự Host Penpot Trên VPS Ubuntu đã khẳng định là chiến lược tối ưu giúp các doanh nghiệp và Design Team vừa chủ động bảo vệ quyền sở hữu trí tuệ bản vẽ, vừa giảm bớt gánh nặng chi phí phần mềm hàng tháng. Sự kết hợp giữa nền tảng mã nguồn mở hiện đại và một hạ tầng máy chủ ổn định, tốc độ cao chính là nền tảng vững chắc để đội ngũ kỹ thuật và thiết kế cùng nhau bứt phá hiệu suất công việc.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung bài viết chỉ mang tính tham khảo. Các lệnh, cấu hình và yêu cầu hệ thống có thể thay đổi theo phiên bản hệ điều hành, phiên bản Penpot, Docker Compose và môi trường thực tế của từng máy chủ. Người đọc nên kiểm thử trên môi trường thử nghiệm, sao lưu dữ liệu đầy đủ và tự đánh giá rủi ro trước khi áp dụng cho hệ thống production.

  • Tự Host Supabase Trên VPS Ubuntu Setup Production An Toàn, Từ A-Z

    Tự Host Supabase Trên VPS Ubuntu Setup Production An Toàn, Từ A-Z

    Tự Host Supabase Trên Ubuntu Server đang trở thành giải pháp tối ưu cho các lập trình viên muốn sở hữu nền tảng Backend-as-a-Service (BaaS) hoàn chỉnh mà không phải gánh chịu chi phí tăng vọt theo quy mô từ các dịch vụ đám mây công cộng. Việc phụ thuộc vào nền tảng đóng gói sẵn khiến bạn khó kiểm soát toàn quyền cơ sở dữ liệu PostgreSQL và đối mặt rủi ro khóa mã nguồn. Với hạ tầng máy chủ linh hoạt từ ThueVPSGiaRe.vn, bạn hoàn toàn có thể tự vận hành cụm Supabase ổn định, an toàn và tối ưu tài nguyên từ A-Z.

    1. Tổng quan kiến trúc và yêu cầu cấu hình phần cứng để tự host Supabase

    Supabase được xem là giải pháp mã nguồn mở thay thế trực tiếp cho Firebase, vận hành dựa trên lõi cơ sở dữ liệu quan hệ PostgreSQL mạnh mẽ kết hợp cùng hàng loạt dịch vụ mở rộng. Thay vì là một ứng dụng nguyên khối (monolithic), Supabase bao gồm một cụm microservices chạy đồng thời khoảng 10 đến 12 container độc lập để xử lý từng chức năng chuyên biệt.

    Các thành phần cốt lõi trong hệ sinh thái Supabase bao gồm:

    • PostgreSQL Database: Trung tâm lưu trữ dữ liệu chính, tích hợp sẵn các phần mở rộng hữu ích như pgvector cho tác vụ AI và tìm kiếm vector.
    • GoTrue (Supabase Auth): Dịch vụ quản lý xác thực người dùng, đăng ký, đăng nhập và tích hợp OAuth providers.
    • PostgREST: Tự động chuyển đổi schema trong PostgreSQL thành chuẩn RESTful API tốc độ cao.
    • Realtime Engine: Lắng nghe các thay đổi dữ liệu từ Postgres qua cơ chế WAL để truyền phát thời gian thực tới máy khách qua WebSockets.
    • Supabase Storage: Quản lý tải lên và phân phối tệp tin với quyền hạn được phân cấp chi tiết qua Row Level Security (RLS) của Postgres.
    • Kong API Gateway: Cổng điều phối API trung tâm, định tuyến lưu lượng vào các service nội bộ và kiểm tra API Key.
    • Supabase Studio: Giao diện Dashboard trực quan trên nền web hỗ trợ quản lý bảng, truy vấn SQL và phân quyền người dùng.

    Vì cụm microservices này vận hành nhiều tiến trình nền, việc phân bổ cấu hình máy chủ không đủ dung lượng có thể kích hoạt trình xử lý Out Of Memory (OOM Killer) của nhân Linux, làm sập container cơ sở dữ liệu.

    yêu cầu cấu hình phần cứng để tự host Supabase trên VPS Ubuntu

    Bạn có thể sử dụng các lệnh kiểm tra cấu hình VPS trước khi cài đặt nhằm đối chiếu với bảng thông số tiêu chuẩn sau:

    Môi trường triển khai Số lượng vCPU Dung lượng RAM Ổ cứng lưu trữ Mục đích khuyến nghị
    Tối thiểu (Dev / Test) 2 vCPU 4 GB RAM 30 – 50 GB SSD Thử nghiệm, dự án cá nhân, lượng request thấp
    Khuyến nghị (Production SME) 4 vCPU 8 GB RAM 80 – 100 GB NVMe Sản phẩm thực tế, chạy ổn định cho ứng dụng vừa
    Quy mô lớn (High Realtime) 8 vCPU trở lên 16 – 32 GB RAM 200 GB+ NVMe Hàng triệu bản ghi, WebSocket kết nối liên tục

    Đối với các hệ thống Production có khối lượng công việc mở rộng, lựa chọn phương án như sử dụng gói máy chủ VPS 8GB RAM sẽ giúp đảm bảo tiến trình PostgreSQL và Kong API Gateway duy trì lượng bộ nhớ đệm cần thiết mà không gặp tình trạng thắt nút cổ chai.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ Tầng Ổn Định Cho Dự Án Tự Host Supabase

    Chạy cụm Supabase đòi hỏi tài nguyên RAM thực và ổ cứng NVMe có tốc độ đọc ghi cao để tránh độ trễ cho PostgreSQL. Fast Byte mang đến các giải pháp máy chủ ảo với quyền quản trị root toàn diện, dễ dàng khởi tạo môi trường Docker trong vài phút mà vẫn tiết kiệm ngân sách.

    Tham khảo VPS giá rẻ

    2. Bước 1: Chuẩn bị Ubuntu Server và cài đặt Docker Compose

    Các phiên bản hệ điều hành được khuyến nghị ưu tiên triển khai gồm Ubuntu 22.04 LTS hoặc Ubuntu 24.04 LTS nhờ tính ổn định lâu dài và khả năng tương thích gói thư viện cao. Trước khi bắt đầu, hãy thực hiện thao tác kết nối SSH vào máy chủ Linux bằng tài khoản có quyền sudo hoặc root để tiến hành cập nhật hệ thống.

    Chuẩn bị Ubuntu Server và cài đặt Docker Compose

    Chạy các lệnh sau để đồng bộ kho phần mềm và nâng cấp các gói hiện có:

    # Cập nhật danh sách gói và nâng cấp hệ thống
    sudo apt update && sudo apt upgrade -y
    
    # Cài đặt các thư viện bổ trợ cần thiết
    sudo apt install -y curl apt-transport-https ca-certificates gnupg lsb-release git

    Supabase sử dụng phiên bản Docker Compose V2 plugin (sử dụng cú pháp docker compose không có dấu gạch ngang). Nếu bạn cần tìm hiểu sâu hơn về kiến trúc container hóa này, có thể đọc thêm bài hướng dẫn cài đặt Docker Compose trên hệ điều hành Ubuntu. Quy trình thiết lập repository chính thức và cài đặt Docker Engine thực hiện như sau:

    # Khởi tạo thư mục keyring và bổ sung GPG key chính thức của Docker
    sudo install -m 0755 -d /etc/apt/keyrings
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
    sudo chmod a+r /etc/apt/keyrings/docker.gpg
    
    # Đăng ký repository của Docker vào danh sách apt
    echo \
      "deb [arch="$(dpkg --print-architecture)" signed-by=/etc/apt/keyrings/docker.gpg] https://download.docker.com/linux/ubuntu \
      "$(. /etc/os-release && echo "$VERSION_CODENAME")" stable" | \
      sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
    
    # Tiến hành cài đặt Docker Engine và Docker Compose plugin
    sudo apt update
    sudo apt install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
    
    # Kiểm tra trạng thái và phiên bản đã cài
    docker --version
    docker compose version

    3. Bước 2: Tải mã nguồn Supabase và cấu hình biến môi trường an toàn

    Để tối ưu hóa không gian lưu trữ và tránh kéo toàn bộ kho tài nguyên khổng lồ của Supabase, chúng ta chỉ lấy phần mã nguồn chứa cấu hình triển khai Docker bằng cách giới hạn độ sâu (shallow clone) với tham số --depth 1.

    # Clone thư mục cấu hình từ repository chính thức của Supabase
    git clone --depth 1 https://github.com/supabase/supabase
    
    # Di chuyển trực tiếp vào thư mục docker
    cd supabase/docker
    
    # Tạo file biến môi trường từ file mẫu
    cp .env.example .env

    Lưu ý bảo mật đặc biệt quan trọng: File mẫu .env.example chỉ chứa các chuỗi mật khẩu và khóa JWT mặc định dùng cho thử nghiệm. Nếu giữ nguyên các giá trị này khi chạy thực tế, bất kỳ đối tượng nào cũng có thể khai thác và kiểm soát cơ sở dữ liệu của bạn. Do đó, bạn cần tạo lại toàn bộ chuỗi bí mật.

    Bạn có thể sinh chuỗi bí mật ngẫu nhiên qua OpenSSL trên cửa sổ dòng lệnh:

    # Sinh chuỗi ngẫu nhiên cho JWT Secret
    openssl rand -hex 32
    
    # Sinh mật khẩu an toàn cho tài khoản root của PostgreSQL
    openssl rand -base64 24

    Ngoài ra, trong thư mục của Supabase có cung cấp sẵn tập lệnh hỗ trợ tự động sinh lại các cặp key bảo mật. Bạn có thể kích hoạt tập lệnh này:

    # Chạy script tự động cập nhật các khóa bí mật vào file .env
    sh ./utils/generate-keys.sh

    Tiếp tục mở file cấu hình bằng lệnh nano .env để rà soát và điều chỉnh các tham số thiết yếu:

    • POSTGRES_PASSWORD: Mật khẩu quản trị cơ sở dữ liệu PostgreSQL.
    • JWT_SECRET: Khóa bí mật dùng để xác thực và ký token cho toàn bộ hệ thống API.
    • ANON_KEY & SERVICE_ROLE_KEY: Token phân quyền truy cập cho client công khai và dịch vụ backend đặc quyền.
    • DASHBOARD_USERNAME & DASHBOARD_PASSWORD: Tài khoản và mật khẩu dùng để truy cập Supabase Studio Dashboard.
    • SUPABASE_PUBLIC_URL & API_EXTERNAL_URL: Địa chỉ tên miền công khai sẽ gắn vào hệ thống (ví dụ: https://api.yourdomain.com hoặc tên miền kèm port http://your-server-ip:8000 khi chưa có domain).

    4. Bước 3: Khởi chạy cụm container Supabase với Docker Compose

    Sau khi đã hoàn tất lưu cấu hình tại file .env, bước tiếp theo là tải các Image chính thức từ Docker Hub và khởi động toàn bộ cụm dịch vụ dưới dạng tiến trình chạy ngầm (detached mode).

    # Kéo phiên bản Docker Image mới nhất của từng container
    docker compose pull
    
    # Kích hoạt toàn bộ cụm dịch vụ
    docker compose up -d

    Để kiểm tra xem các container đã hoạt động đầy đủ và không gặp sự cố crash, hãy sử dụng lệnh liệt kê trạng thái tiến trình:

    # Kiểm tra danh sách container đang chạy
    docker compose ps

    Kết quả hiển thị trên terminal cần đảm bảo các service thiết yếu như supabase-db, supabase-kong, supabase-auth, supabase-studio, supabase-storage đều hiển thị trạng thái Up hoặc healthy. Tại thời điểm này, bạn đã có thể truy cập trực tiếp trang quản trị Supabase Studio qua địa chỉ IP máy chủ tại cổng mặc định http://your-server-ip:8000.

    chạy cụm container Supabase với Docker Compose

    5. Bước 4: Thiết lập Reverse Proxy Nginx, SSL và tường lửa UFW

    Trong môi trường vận hành thực tế, việc mở trực tiếp các cổng nội bộ như port 8000 hay port 3000 ra môi trường Internet tiềm ẩn nhiều rủi ro bị quét cổng và tấn công. Giải pháp chuyên nghiệp là sử dụng máy chủ web đóng vai trò làm reverse proxy tiếp nhận lưu lượng truy cập qua giao thức HTTPS chuẩn bảo mật.

    Nhờ khả năng xử lý đồng thời hàng nghìn kết nối nhẹ nhàng, lựa chọn triển khai web server mã nguồn mở Nginx làm cổng chuyển tiếp lưu lượng là phương án được sử dụng phổ biến nhất. Cài đặt Nginx cùng công cụ Certbot thông qua lệnh:

    # Cài đặt Nginx và Certbot hỗ trợ Nginx
    sudo apt install -y nginx certbot python3-certbot-nginx

    Tạo tệp cấu hình Virtual Host tại đường dẫn /etc/nginx/sites-available/supabase.conf để phân luồng truy cập cho Supabase Studio (quản trị) và Kong (API Gateway):

    # Cấu hình chuyển tiếp cho Supabase Studio Dashboard
    server {
        server_name studio.yourdomain.com;
    
        location / {
            proxy_pass http://127.0.0.1:3000;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;
        }
    }
    
    # Cấu hình chuyển tiếp cho Kong API Gateway
    server {
        server_name api.yourdomain.com;
    
        location / {
            proxy_pass http://127.0.0.1:8000;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;
        }
    }

    Kích hoạt cấu hình, kiểm tra cú pháp và tiến hành cài đặt chứng chỉ SSL Let’s Encrypt qua Certbot hoàn toàn tự động:

    # Tạo liên kết kích hoạt Virtual Host
    sudo ln -s /etc/nginx/sites-available/supabase.conf /etc/nginx/sites-enabled/
    
    # Kiểm tra cú pháp cấu hình Nginx
    sudo nginx -t
    
    # Tải lại dịch vụ Nginx
    sudo systemctl reload nginx
    
    # Đăng ký và gắn chứng chỉ SSL miễn phí tự động
    sudo certbot --nginx -d studio.yourdomain.com -d api.yourdomain.com

    Để hoàn thiện lớp phòng vệ cho máy chủ, bạn cần tiến hành thiết lập tường lửa UFW trên Ubuntu nhằm đóng toàn bộ các cổng truy cập cơ sở dữ liệu nhạy cảm (như 5432, 6543) và cổng dịch vụ nội bộ, chỉ giữ lại các cổng công khai cần thiết:

    # Đặt chính sách mặc định: Chặn toàn bộ kết nối vào, cho phép kết nối ra
    sudo ufw default deny incoming
    sudo ufw default allow outgoing
    
    # Chỉ mở cổng SSH và cổng web Nginx tiếp nhận
    sudo ufw allow 22/tcp
    sudo ufw allow 80/tcp
    sudo ufw allow 443/tcp
    
    # Kích hoạt tường lửa UFW
    sudo ufw enable
    sudo ufw status

    6. Bước 5: Giám sát Container, sao lưu cơ sở dữ liệu và phương án độ sẵn sàng cao

    Khi đưa hệ thống vào hoạt động liên tục, việc giám sát nhật ký (logs) và sao lưu định kỳ là điều kiện tiên quyết giúp bạn chủ động xử lý sự cố phát sinh.

    1. Kiểm tra nhật ký hoạt động của các dịch vụ: Khi gặp lỗi phản hồi từ API hoặc bảng điều khiển không tải được dữ liệu, bạn có thể kiểm tra trực tiếp nhật ký từ container cơ sở dữ liệu hoặc gateway:

    # Theo dõi log thời gian thực của container cơ sở dữ liệu PostgreSQL
    docker compose logs -f db
    
    # Theo dõi log xử lý định tuyến của Kong API Gateway
    docker compose logs -f kong

    2. Sao lưu cơ sở dữ liệu PostgreSQL: Bạn có thể xuất toàn bộ schema và dữ liệu từ bên trong container bằng tiện ích pg_dumpall mà không cần cài đặt thêm công cụ bên ngoài máy chủ:

    # Xuất và nén toàn bộ database ra file sql.gz theo mốc thời gian
    docker compose exec -T db pg_dumpall -U postgres | gzip > "supabase_backup_$(date +%Y%m%d_%H%M%S).sql.gz"

    3. Phương án mở rộng và đảm bảo tính sẵn sàng cao (High Availability):

    • Mô hình dự phòng cơ bản (Basic Redundancy): Sử dụng 2 máy chủ ảo kết hợp dịch vụ DNS/Proxy như Cloudflare để xử lý failover. Một node chính chạy toàn bộ dịch vụ Supabase, node phụ chạy PostgreSQL ở chế độ streaming replication để sẵn sàng thay thế khi node chính gặp sự cố phần cứng.
    • Cụm máy chủ PostgreSQL (Cluster Failover): Xây dựng cụm tối thiểu 3 node PostgreSQL với công cụ Patroni quản lý tự động chuyển đổi dự phòng (automatic failover), trong khi các dịch vụ stateless (Kong, PostgREST, Auth) chạy phân tách riêng biệt.
    • Nâng cấp hạ tầng khi mở rộng: Khi quy mô cơ sở dữ liệu vượt ngưỡng hàng trăm Gigabyte và tính năng tìm kiếm qua pgvector đòi hỏi tốc độ I/O cao, việc hiểu rõ bản chất sự khác biệt giữa VPS và Cloud Server sẽ giúp bạn đưa ra quyết định chuyển đổi hạ tầng đúng thời điểm, đảm bảo khả năng mở rộng tài nguyên tính toán tức thì mà không gián đoạn dịch vụ.

    7. Câu hỏi thường gặp khi tự host Supabase trên Ubuntu (FAQ)

    Dưới đây là giải đáp chi tiết cho những vướng mắc phổ biến nhất khi triển khai cụm Supabase tự quản lý trên máy chủ ảo Ubuntu Server.

    Tự host Supabase có hỗ trợ đầy đủ các tính năng như bản Cloud không?

    Phiên bản tự host cung cấp hầu hết các tính năng cốt lõi gồm PostgreSQL Database, Row Level Security, Auth, Realtime, RESTful API và Storage. Tuy nhiên, một số thành phần như Supabase Edge Functions (dùng Deno runtime) đòi hỏi cấu hình bổ sung phức tạp hơn so với việc kích hoạt sẵn trên giao diện bản Cloud quản lý tập trung.

    Tại sao container supabase-db thường xuyên bị tự động thoát (Exit/Restart)?

    Nguyên nhân phổ biến nhất là máy chủ bị tràn RAM. Khi dung lượng RAM thực tế dưới 4GB, tiến trình PostgreSQL và các container đi kèm sẽ bị cơ chế Out Of Memory (OOM Killer) của Linux can thiệp để bảo vệ hệ điều hành. Hãy nâng cấp RAM hoặc tạo thêm phân vùng bộ nhớ ảo (Swap) để xử lý tạm thời.

    Tôi có thể kết nối công cụ quản trị ngoài (DBeaver, pgAdmin) vào Supabase không?

    Có. Bạn có thể kết nối trực tiếp vào PostgreSQL qua cổng mặc định 5432 (hoặc qua port bouncers 6543) bằng mật khẩu khai báo trong biến POSTGRES_PASSWORD. Để an toàn, chỉ nên mở cổng này cho địa chỉ IP mạng cố định của bạn hoặc kết nối thông qua SSH Tunnel thay vì mở công khai qua Internet.

    Quy trình Tự Host Supabase Trên Ubuntu Server mang lại cho các nhóm phát triển quyền làm chủ toàn diện hạ tầng cơ sở dữ liệu, tối ưu chi phí vận hành và linh hoạt tùy chỉnh môi trường phần mềm theo nhu cầu. Để hệ thống luôn chạy mượt mà, hãy chú trọng phân bổ dung lượng phần cứng tối thiểu từ 4GB đến 8GB RAM, luôn tái tạo chuỗi bảo mật JWT trước khi chạy Production và định cấu hình Nginx Reverse Proxy kèm tường lửa nghiêm ngặt. Khi được thiết lập chuẩn xác, bạn sẽ sở hữu một hệ thống BaaS mạnh mẽ phục vụ hàng ngàn người dùng mà không lo phụ thuộc vào nền tảng thứ ba.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung bài viết mang tính tham khảo kỹ thuật. Các cú pháp lệnh, file cấu hình và thông số hệ thống có thể thay đổi tùy thuộc vào phiên bản phát hành của Supabase, Docker cũng như môi trường hệ điều hành cụ thể. Quản trị viên nên chủ động kiểm thử trong môi trường thử nghiệm, thiết lập cơ chế sao lưu dữ liệu và đánh giá rủi ro an toàn mạng trước khi áp dụng vào hệ thống thực tế.

  • Hướng Dẫn Self-Host Karakeep Trên VPS Với AI Tagging Bằng Docker A-Z

    Hướng Dẫn Self-Host Karakeep Trên VPS Với AI Tagging Bằng Docker A-Z


    Self-Host Karakeep trên VPS là giải pháp tối ưu giúp bạn sở hữu một kho lưu trữ bookmark và ghi chú cá nhân hóa mạnh mẽ mà không lo rò rỉ dữ liệu quan trọng. Khi lưu lại hàng trăm liên kết mỗi tuần, việc tìm kiếm lại thông tin thường biến thành “cơn ác mộng” nếu thiếu sự sắp xếp khoa học. Thay vì gửi toàn bộ nội dung web nhạy cảm đến các nền tảng trí tuệ nhân tạo đám mây của bên thứ ba, bạn hoàn toàn có thể triển khai hệ thống gắn tag tự động bằng mô hình AI cục bộ với Ollama trên nền tảng máy chủ ảo tối ưu từ ThueVPSGiaRe.vn.
    1. Chuẩn bị môi trường VPS và tài nguyên hệ thống

    Trước khi đi vào các thao tác kỹ thuật, bạn cần chuẩn bị một máy chủ đáp ứng đủ yêu cầu tính toán của mô hình AI nội bộ. Hệ thống hướng dẫn trong bài viết này vận hành ổn định trên nền tảng Ubuntu 24.04 LTS với quyền quản trị root/sudo.

    • Tài nguyên phần cứng khuyến nghị: Cần chuẩn bị máy chủ ảo sở hữu tối thiểu 4 CPU cores và 8 GB RAM. Mô hình AI phục vụ tagging sẽ tiêu tốn khoảng 3.2 GB bộ nhớ RAM trong trạng thái được nạp (loaded). Bạn có thể tham khảo thêm khả năng chạy container của VPS 8GB RAM để nắm rõ cách tối ưu phân bổ tài nguyên.
    • Tên miền và bản ghi DNS: Chuẩn bị một tên miền hoặc subdomain (ví dụ: karakeep.example.com) đã tạo bản ghi A trỏ chính xác về địa chỉ IPv4 của VPS. Hãy đảm bảo bạn biết cách trỏ domain chuẩn xác về địa chỉ IP máy chủ của mình.
    • Cổng mạng (Ports): Đảm bảo cổng 80 và 443 mở ra ngoài internet để web server Caddy có thể tự động cấp phát và gia hạn chứng chỉ SSL Let’s Encrypt.
    • Môi trường máy chủ: Sử dụng máy chủ mới hoặc máy chủ chưa có tiến trình nào chiếm dụng port 80 và 443. Việc xử lý suy luận AI trên CPU sẽ có tốc độ chậm hơn so với GPU chuyên dụng, tuy nhiên tác vụ tagging này chạy hoàn toàn ở chế độ nền (background) nên bạn không nhất thiết phải đầu tư máy chủ GPU tốn kém.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ Tầng Tối Ưu Cho Ứng Dụng Docker & AI Cục Bộ

    Chạy các tác vụ Docker đa container cùng mô hình suy luận ngôn ngữ cục bộ đòi hỏi đường truyền ổn định và ổ cứng truy xuất nhanh. Fast Byte mang đến giải pháp máy chủ ảo với chi phí tiết kiệm, trang bị SSD NVMe hiệu năng cao giúp việc đọc/ghi database Meilisearch và tải mô hình Ollama diễn ra nhanh chóng.

    Tham khảo VPS giá rẻ

    2. Cài đặt Docker, Docker Compose V2 và Caddy Server

    Hệ thống của chúng ta sử dụng Docker để cô lập 4 dịch vụ chính và Caddy làm reverse proxy tiếp nhận lưu lượng truy cập từ bên ngoài. Tất cả các gói phần mềm cần thiết đều có thể cài đặt trực tiếp từ kho lưu trữ chính thức của Ubuntu.

    Cài đặt Docker, Docker Compose V2 và Caddy Server

    Trước tiên, bạn cập nhật danh sách gói và tiến hành cài đặt Docker Engine, Docker Compose V2, máy chủ web Caddy, OpenSSL cùng cURL:

    sudo apt-get update
    sudo apt-get install -y docker.io docker-compose-v2 caddy openssl curl
    sudo systemctl enable --now docker

    Nếu bạn muốn hiểu rõ hơn cơ chế quản lý container hiện đại này, bài viết cài đặt và sử dụng Docker Compose trên Ubuntu chuẩn V2 sẽ cung cấp góc nhìn toàn diện cho bạn.

    Tiếp theo, hãy thiết lập tường lửa UFW để bảo vệ máy chủ. Bạn mở cổng dịch vụ SSH, HTTP (cổng 80) và HTTPS (cổng 443). Hãy lưu ý thay thế cổng SSH thực tế nếu máy chủ của bạn không dùng cổng 22 mặc định:

    sudo ufw allow OpenSSH
    sudo ufw allow 80/tcp
    sudo ufw allow 443/tcp

    Để chủ động kiểm soát lưu lượng mạng vào máy chủ, bạn nên xem thêm bài viết thiết lập tường lửa UFW trên Ubuntu. Lưu ý quan trọng: Bản thân ứng dụng Karakeep chỉ lắng nghe trên cổng nội bộ 127.0.0.1:3000, do đó bạn không cần và không được mở cổng 3000 trên tường lửa UFW ra bên ngoài.

    3. Thiết lập biến môi trường và file Compose cho Karakeep

    Chúng ta sẽ gom toàn bộ cấu hình vào một thư mục làm việc riêng biệt, đồng thời phân quyền chặt chẽ cho file chứa các khóa bí mật để tăng cường an toàn hệ thống.

    Thiết lập biến môi trường và file Compose cho Karakeep

    Khởi tạo thư mục dự án và tạo file .env với quyền hạn giới hạn chỉ người dùng sở hữu mới có quyền đọc ghi:

    mkdir -p ~/karakeep
    cd ~/karakeep
    touch .env
    chmod 600 .env
    openssl rand -hex 32
    openssl rand -hex 32

    Lệnh openssl rand -hex 32 sẽ in ra 2 chuỗi ngẫu nhiên có độ dài 32 ký tự. Bạn mở file ~/karakeep/.env và điền nội dung cấu hình như sau (thay thế chuỗi ngẫu nhiên thứ nhất vào NEXTAUTH_SECRET, chuỗi thứ hai vào MEILI_MASTER_KEY):

    KARAKEEP_VERSION=0.33.2
    NEXTAUTH_URL=https://karakeep.example.com
    NEXTAUTH_SECRET=REPLACE_WITH_FIRST_VALUE
    MEILI_MASTER_KEY=REPLACE_WITH_SECOND_VALUE
    OPENAI_API_KEY=ollama
    INFERENCE_TEXT_MODEL=qwen3:4b-instruct
    INFERENCE_JOB_TIMEOUT_SEC=300

    Giải thích các biến đặc thù: Giá trị OPENAI_API_KEY=ollama chỉ là một chuỗi giữ chỗ (placeholder), không phải API key trả phí. Karakeep bắt buộc cần một giá trị tại biến này để gọi giao diện API tương thích chuẩn OpenAI của Ollama. Tham số INFERENCE_JOB_TIMEOUT_SEC=300 kéo dài thời gian chờ lên 5 phút để mô hình chạy trên CPU có đủ thời gian hoàn thành tác vụ (mức mặc định 30 giây là quá ngắn khi xử lý không có GPU).

    Tiếp tục tạo file cấu hình triển khai dịch vụ ~/karakeep/compose.yaml với nội dung:

    services:
      web:
        image: ghcr.io/karakeep-app/karakeep:${KARAKEEP_VERSION}
        restart: unless-stopped
        env_file:
          - .env
        environment:
          DATA_DIR: /data
          MEILI_ADDR: http://meilisearch:7700
          BROWSER_WEB_URL: http://chrome:9222
          OPENAI_BASE_URL: http://ollama:11434/v1
        ports:
          - "127.0.0.1:3000:3000"
        volumes:
          - data:/data
        depends_on:
          - meilisearch
          - chrome
          - ollama
    
      chrome:
        image: ghcr.io/karakeep-app/karakeep-chrome:151.0.7922.47-r1
        restart: unless-stopped
        init: true
        command:
          - --disable-gpu
          - --disable-dev-shm-usage
          - --hide-scrollbars
          - --disable-blink-features=AutomationControlled
          - --window-size=1440,900
    
      meilisearch:
        image: getmeili/meilisearch:v1.41.0
        restart: unless-stopped
        environment:
          MEILI_MASTER_KEY: ${MEILI_MASTER_KEY}
          MEILI_NO_ANALYTICS: "true"
        volumes:
          - meilisearch:/meili_data
    
      ollama:
        image: ollama/ollama:0.35.1
        restart: unless-stopped
        volumes:
          - ollama:/root/.ollama
    
    volumes:
      data:
      meilisearch:
      ollama:

    Cấu trúc file Compose trên dựa trên bản chuẩn upstream của tác giả với các image tag được ghim phiên bản cụ thể (pinned versions) và bổ sung dịch vụ Ollama. Container ollama không hề có mục ports, nghĩa là cổng của nó không bị public ra máy chủ host. Các container trong cùng mạng Compose nội bộ vẫn có thể kết nối với nhau bình thường. Tuyệt đối không đưa cổng 11434 ra môi trường internet vì mặc định Ollama không có cơ chế xác thực người dùng.

    Kiểm tra cú pháp và tiến hành kích hoạt toàn bộ hệ thống:

    sudo docker compose config --quiet
    sudo docker compose up -d
    sudo docker compose ps
    curl -s http://127.0.0.1:3000/api/health

    Kết quả trả về yêu cầu cả 4 container đều ở trạng thái Up, và lệnh kiểm tra health check trả về chuỗi JSON: {"status":"ok","message":"Web app is working"}.

    4. Tìm hiểu vai trò 4 dịch vụ cốt lõi trong stack

    Để dễ dàng làm chủ và bảo trì hệ thống lâu dài, bạn cần hiểu rõ cách thức phân chia trách nhiệm giữa các container và luồng dữ liệu bên trong.

    • Web service (Karakeep): Đóng vai trò ứng dụng trung tâm, hiển thị giao diện người dùng và điều phối toàn bộ các tác vụ nền (background jobs).
    • Chrome service (Headless Chrome): Thực hiện việc truy cập, tải toàn bộ nội dung của trang liên kết và chụp ảnh hoặc kết xuất nội dung văn bản.
    • Meilisearch: Cơ sở dữ liệu tìm kiếm tốc độ cao, lập chỉ mục toàn bộ văn bản được cào về để bạn có thể tìm kiếm toàn văn sau này.
    • Ollama: Nền tảng chạy mô hình AI cục bộ, tiếp nhận nội dung văn bản tóm tắt từ web service để suy luận và đề xuất các nhãn dán (tags) tương ứng.

    Caddy hoạt động như một điểm truy cập HTTPS công khai an toàn; nó chuyển tiếp yêu cầu đến ứng dụng web trên địa chỉ loopback của máy chủ. Trình duyệt người dùng không bao giờ cần kết nối trực tiếp đến Meilisearch hay Ollama.

    Các volume được đặt tên (named volumes) giúp lưu trữ dữ liệu ứng dụng, chỉ mục tìm kiếm và các mô hình AI đã tải về nằm ngoài tầng ghi của container. Nhờ đó, việc khởi tạo lại container sẽ không làm mất dữ liệu.

    Lưu ý về tính riêng tư: Việc chạy suy luận AI cục bộ không biến thao tác thu thập trang thành hoạt động offline. Trình cào dữ liệu (crawler) vẫn phải kết nối internet tới các trang web bạn lưu, quá trình cài đặt stack và mô hình vẫn cần tải xuống từ mạng. Lợi ích bảo mật ở đây là nội dung trang web được phân tích bởi chính mô hình AI do bạn làm chủ, không gửi dữ liệu tới OpenAI hay bất kỳ nhà cung cấp AI đám mây nào khác.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    VPS đủ 8 GB RAM — điều kiện để AI tagging cục bộ chạy ổn định

    Model tagging chiếm khoảng 3,2 GB bộ nhớ khi được nạp, cộng thêm Chrome, Meilisearch và chính ứng dụng web, nên 8 GB RAM là mức thoải mái cho stack này. VPS giá rẻ của Fast Byte dùng CPU Intel Gold và SSD NVMe U.2, phù hợp để chạy Karakeep cho cá nhân hoặc nhóm nhỏ mà không cần máy chủ GPU.

    Tham khảo VPS giá rẻ

    5. Tải mô hình AI Qwen3 phục vụ gán nhãn tự động

    Sau khi container Ollama đã vận hành, bạn cần tải mô hình AI được chỉ định trong cấu hình về hệ thống để thực hiện nhiệm vụ đọc văn bản và đề xuất nhãn dán.

    Thực thi lệnh tải mô hình trực tiếp bên trong container Ollama:

    sudo docker compose exec ollama ollama pull qwen3:4b-instruct
    sudo docker compose exec ollama ollama list

    Dung lượng tải về của mô hình khoảng 2.5 GB. Mô hình qwen3:4b-instruct được phát hành dưới giấy phép mã nguồn mở Apache 2.0, có khả năng tuân thủ cấu trúc định dạng tag của Karakeep rất chuẩn xác và có thể vận hành mượt mà trên môi trường CPU thuần túy.

    Bạn chỉ nên sử dụng duy nhất một mô hình tagging tại một thời điểm: Ollama sẽ giữ mô hình được sử dụng gần nhất trong RAM trong vài phút, và việc nạp cùng lúc hai mô hình có thể làm cạn kiệt bộ nhớ RAM của một VPS cấu hình nhỏ dẫn đến lỗi treo máy.

    6. Cấu hình Reverse Proxy HTTPS tự động qua Caddy

    Caddy là web server hiện đại có khả năng tự động xin và kích hoạt chứng chỉ SSL thông qua Let’s Encrypt mà không cần cấu hình dòng lệnh cronjob phức tạp.

    Cấu hình Reverse Proxy HTTPS tự động qua Caddy

    Đầu tiên, hãy tạo một bản sao lưu cho file cấu hình Caddy mặc định:

    sudo cp -a /etc/caddy/Caddyfile /etc/caddy/Caddyfile.bak

    Thay nội dung file /etc/caddy/Caddyfile bằng khối lệnh chuyển tiếp đơn giản sau (thay thế karakeep.example.com bằng tên miền thật của bạn):

    karakeep.example.com {
        reverse_proxy 127.0.0.1:3000
    }

    Tiến hành kiểm tra tính hợp lệ của cấu hình và reload lại Caddy:

    sudo caddy validate --config /etc/caddy/Caddyfile
    sudo systemctl reload caddy
    curl -sI https://karakeep.example.com/api/health

    Khi lệnh kiểm tra cuối cùng trả về mã HTTP/2 200 mà không xuất hiện bất kỳ cảnh báo lỗi SSL nào, website của bạn đã sẵn sàng truy cập an toàn qua kết nối HTTPS.

    7. Khởi tạo tài khoản quản trị và khóa cổng đăng ký

    Bất kỳ ai biết được tên miền của bạn đều có thể đăng ký tài khoản cho đến khi tính năng này bị vô hiệu hóa. Do đó, việc thiết lập bảo mật phân quyền là bước bắt buộc ngay sau khi đưa hệ thống lên mạng internet.

    1. Mở trình duyệt web, truy cập đường dẫn https://karakeep.example.com và bấm chọn Sign up. Tài khoản đầu tiên đăng ký trên hệ thống sẽ tự động được gán quyền quản trị viên cao nhất (administrator). Bạn có thể tìm hiểu thêm về đặc quyền này qua hướng dẫn về quyền root trong môi trường máy chủ Linux.
    2. Ngay sau khi đăng ký thành công, hãy khóa tính năng đăng ký tự do bằng cách thêm dòng sau vào cuối file ~/karakeep/.env:
      DISABLE_SIGNUPS=true
    3. Áp dụng thay đổi cấu hình bằng cách chạy lại lệnh:
      sudo docker compose up -d

    Sau khi cập nhật, hãy đăng xuất tài khoản và truy cập lại trang đăng ký để kiểm tra. Hệ thống lúc này sẽ hiển thị thông báo Sign Up Unavailable. Nếu muốn tạo thêm tài khoản cho đồng nghiệp hay người thân, bạn có thể đăng nhập tài khoản quản trị, truy cập menu cá nhân, chọn Admin Settings → Users List và tạo tài khoản thủ công qua nút Create User.

    8. Kiểm tra tính năng lưu trữ, tìm kiếm và gán nhãn AI

    Bây giờ là lúc bạn thử nghiệm khả năng tự động hóa vượt trội của Karakeep kết hợp cùng mô hình ngôn ngữ lớn Qwen3 chạy trên Ollama.

    • Lưu liên kết đầu tiên: Chọn mục New Item, dán đường dẫn của một bài báo trực tuyến bất kỳ và lưu lại. Karakeep trước hết sẽ dùng Chrome không đầu để cào dữ liệu trang, sau đó đưa bài viết vào hàng đợi suy luận để AI xử lý nhãn.
    • Thời gian phản hồi của mô hình: Các nhãn dán gợi ý thường xuất hiện trên thẻ bookmark trong vòng 1 đến 2 phút. Hệ thống xử lý từng liên kết một theo thứ tự. Lần xử lý đầu tiên sau một khoảng thời gian dài không hoạt động sẽ mất thời gian hơn đôi chút vì Ollama cần nạp lại mô hình vào RAM.
    • Ví dụ thực tế: Một bài viết Wikipedia về espresso sau khi lưu đã được AI tự động gắn các tag: Espresso, Espresso Machine, Coffee Machine, Cappuccino, và Third-Wave Coffee. Những mô hình ngôn ngữ nhỏ nhận diện chủ đề chính rất tốt nhưng đôi khi có thể gán thêm những nhãn có tính liên quan rộng, vì vậy bạn nên xem lại và xóa bớt các tag không cần thiết.
    • Ghi chú và hình ảnh: Ghi chú dạng văn bản (text notes) cũng được AI gán tag tương tự. Riêng bookmark dạng hình ảnh sẽ đòi hỏi mô hình thị giác chuyên biệt (vision-capable model) – cấu hình hiện tại trong bài viết này chưa thiết lập cho tác vụ ảnh.
    • Tùy biến chỉ dẫn AI: Thử tìm kiếm một từ khóa bất kỳ nằm trong thân bài viết để kiểm tra Meilisearch đã lập chỉ mục chính xác chưa. Để định hướng phong cách gán nhãn cho AI theo ý muốn (ví dụ: ngôn ngữ ưu tiên hoặc phong cách đặt tên), hãy vào menu cá nhân, chọn User Settings → AI Settings và bổ sung chỉ dẫn cụ thể.
    • Tiện ích mở rộng & App: Khi cài đặt tiện ích trình duyệt hoặc ứng dụng di động của Karakeep, bạn chỉ cần nhập địa chỉ máy chủ https://karakeep.example.com và đăng nhập bằng tài khoản cá nhân vừa tạo.

    9. Các bước nghiệm thu hệ thống trước khi import hàng loạt

    Trước khi chuyển toàn bộ hàng ngàn liên kết từ trình duyệt cũ sang Karakeep, bạn nên thực hiện quy trình kiểm tra từng giai đoạn để đảm bảo mọi thành phần trong cụm dịch vụ phối hợp nhịp nhàng.

    • Kiểm tra 3 bước độc lập: Bắt đầu bằng việc thêm 1 trang bài viết công khai tiêu chuẩn. Đảm bảo tiêu đề và nội dung hiển thị đầy đủ, tìm kiếm từ khóa trong thân bài có kết quả, và AI hoàn thành việc gán nhãn. Ba bước này xác nhận 3 điều khác nhau: lưu URL xác nhận bộ nhớ hoạt động, tìm kiếm được xác nhận crawler và Meilisearch hoạt động, còn có tag xác nhận mô hình AI hoàn tất tác vụ. Phản hồi health check thông thường không thể chứng minh cả 3 công đoạn đều chạy chuẩn.
    • Xem xét chất lượng tag: Đánh giá một vài đề xuất nhãn đầu tiên trước khi đổ dữ liệu lớn vào thư viện. Mô hình có thể tạo ra các nhãn hợp lệ nhưng quá rộng hoặc chỉ liên quan gián tiếp. Hãy coi tag như những gợi ý có thể chỉnh sửa chứ không phải bản tóm tắt hoàn hảo của nội dung gốc. Việc giữ các nhãn dán nhất quán sẽ hữu ích hơn việc chấp nhận hàng loạt nhãn trùng lặp gần nghĩa.
    • Tránh nhầm lẫn hàng đợi với lỗi: Sau một thời gian không sử dụng, hãy kiên nhẫn chờ vài chục giây để Ollama nạp lại mô hình trước khi cho rằng tác vụ gán nhãn bị lỗi. Việc import cùng lúc một lượng lớn bookmark sẽ tạo ra hàng đợi xử lý nền thay vì phân bổ tiến trình riêng cho từng liên kết. Bạn cũng nên tránh việc liên tục thay đổi mô hình AI trong lúc đang chuẩn đoán lỗi, vì điều đó làm cho vấn đề đầy bộ nhớ RAM và lỗi tên mô hình trở nên phức tạp, khó phân biệt với lỗi thu thập dữ liệu web.

    10. Hướng dẫn xử lý các lỗi thường gặp khi tự host Karakeep

    Nếu gặp sự cố trong quá trình sử dụng, bước đầu tiên luôn là kiểm tra nhật ký hoạt động (logs) của container ứng dụng web:

    cd ~/karakeep
    sudo docker compose logs --tail=50 web

    Các tình huống lỗi phổ biến và hướng xử lý chi tiết:

    • Không xuất hiện bất kỳ nhãn dán nào: Hãy tìm các dòng log chứa từ khóa [inference]. Nếu gặp lỗi 404 model '...' not found, nguyên nhân là giá trị khai báo tại INFERENCE_TEXT_MODEL trong file .env không khớp chính xác với tên hiển thị trong lệnh ollama list. Nếu xuất hiện inference job failed: Error: Timeout, điều này có nghĩa là mô hình AI cần nhiều thời gian hơn mức quy định của INFERENCE_JOB_TIMEOUT_SEC; hãy tăng thông số này lên và áp dụng lại bằng lệnh sudo docker compose up -d.
    • Bookmark chỉ hiển thị mỗi URL, không có tiêu đề hay tag: Quá trình cào dữ liệu thất bại nên AI không có dữ liệu đầu vào để phân tích. Tìm kiếm dòng chữ Crawling job failed trong log và kiểm tra xem máy chủ có kết nối mạng được tới trang web đó hay không. Sau đó, bạn có thể mở menu của bookmark đó và chọn More → Refresh để hệ thống tiến hành cào và gán nhãn lại.
    • Thông báo “Failed to find potentially relevant tags … Document not found”: Dòng thông báo này có thể hiển thị đối với các bookmark mới tạo trước khi Meilisearch kịp cập nhật chỉ mục tìm kiếm. Lỗi này hoàn toàn bình thường và không làm gián đoạn tiến trình gán tag của hệ thống.
    • Ollama tự động dừng hoặc máy chủ bị đơ (freeze): Kích thước mô hình vượt quá dung lượng bộ nhớ khả dụng. Hãy kiểm tra tình trạng tài nguyên bằng lệnh free -h và kiểm tra thông điệp tràn bộ nhớ bằng sudo dmesg | grep -i oom. Bạn cần cấp thêm RAM cho máy chủ, chỉ duy trì 1 mô hình hoạt động duy nhất hoặc đổi sang mô hình ngôn ngữ có kích thước nhẹ hơn. Trong quá trình vận hành, bạn có thể tham khảo thêm các lệnh kiểm tra cấu hình VPS cũng như cách tạo file Swap trên VPS Linux để hỗ trợ bù đắp bộ nhớ tức thời khi RAM đạt đỉnh.
    • Chỉnh sửa file .env nhưng không có hiệu lực: Bạn bắt buộc phải chạy lệnh sudo docker compose up -d để Docker cập nhật lại cấu hình. Thao tác restart container thông thường sẽ không nạp lại nội dung mới từ file biến môi trường.
    • Lỗi chứng chỉ SSL / Caddy không cấp phát được HTTPS: Hãy kiểm tra xem bản ghi A của tên miền đã thực sự trỏ về đúng IP máy chủ chưa, đồng thời đảm bảo cổng 80 và 443 đang mở và không bị xung đột. Bạn có thể kiểm tra nhật ký chi tiết của Caddy qua lệnh sudo journalctl -u caddy -n 50 --no-pager. Bạn cũng có thể xem thêm hướng dẫn về cài đặt chứng chỉ SSL Let’s Encrypt để nắm rõ nguyên lý xác thực tên miền qua cổng mạng.

    Ngoài ra, sau một thời gian dài sử dụng các image và container kiểm thử, dung lượng ổ đĩa của bạn có thể tăng lên. Hãy áp dụng cách dọn dẹp Docker giải phóng dung lượng định kỳ để hệ thống luôn vận hành trơn tru và tránh hiện tượng đầy ổ đĩa làm gián đoạn database.

    Thiết lập thành công mô hình Self-Host Karakeep trên VPS kết hợp trí tuệ nhân tạo cục bộ mang lại sự cân bằng hoàn hảo giữa tính tiện lợi hiện đại và quyền riêng tư dữ liệu tuyệt đối. Toàn bộ các bookmark, trang web đã lưu trữ cùng hệ thống tìm kiếm Meilisearch đều được giữ trọn vẹn trên máy chủ riêng của bạn. Để duy trì hệ thống ổn định lâu dài, hãy luôn chú trọng đến việc cấp phát đủ dung lượng RAM cho Ollama, phân quyền bảo mật file cấu hình và sao lưu dữ liệu named volume định kỳ.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Lưu ý: Toàn bộ thông tin và hướng dẫn kỹ thuật trong bài viết chỉ mang tính chất tham khảo. Các câu lệnh, thông số môi trường và cú pháp cấu hình có thể thay đổi tùy thuộc vào phiên bản phát hành của Karakeep, Ollama, Docker cũng như hệ điều hành cụ thể. Quản trị viên nên chủ động kiểm tra kỹ lưỡng, sao lưu dữ liệu dự phòng và đánh giá tài nguyên máy chủ trước khi đưa vào vận hành thực tế.

  • [A–Z] Hướng Dẫn Tự Host Umami Trên VPS Siêu Nhẹ, Thay GA4 Với 15 Phút

    [A–Z] Hướng Dẫn Tự Host Umami Trên VPS Siêu Nhẹ, Thay GA4 Với 15 Phút

    Tự Host Umami Trên VPS đang là giải pháp thay thế hoàn hảo cho Google Analytics khi doanh nghiệp của bạn đối mặt với các rào cản về quyền riêng tư, banner cookie phức tạp và mã theo dõi làm chậm tốc độ tải trang. Thay vì phụ thuộc vào các dịch vụ bên thứ ba cồng kềnh, bạn hoàn toàn có thể tự triển khai một nền tảng phân tích mã nguồn mở gọn nhẹ, tối ưu chi phí hạ tầng tại ThueVPSGiaRe.vn và làm chủ 100% dữ liệu người dùng.

    Có nên thay thế Google Analytics bằng Umami Analytics không?

    Google Analytics (GA4) ngày càng trở nên phức tạp và nặng nề đối với nhu cầu theo dõi thông lượng truy cập của phần lớn website hiện nay.

    Umami thực hiện việc thu thập dữ liệu hoàn toàn dưới dạng ẩn danh. Công cụ không lưu thông tin cá nhân, không dùng cookie, không theo dõi hành vi người dùng trên nhiều website và đáp ứng đầy đủ các yêu cầu của GDPR. Nhờ vậy, bạn có thể loại bỏ thanh thông báo cookie khỏi website mà không phải lo lắng về vấn đề theo dõi người dùng.

    Umami
    Umami “Nguồn: Internet”

    Việc chuyển sang Umami Analytics mang đến giải pháp tinh gọn, minh bạch và an toàn hơn cho người vận hành:

    • Bảo vệ quyền riêng tư, miễn nhiễm GDPR/CCPA: Umami thu thập số liệu truy cập hoàn toàn ẩn danh, không lưu trữ thông tin nhận dạng cá nhân (PII), không sử dụng cookie theo dõi chéo giữa các website, nhờ đó loại bỏ triệt để pop-up cookie banner gây cản trở trải nghiệm xem trang.
    • Tải trang siêu tốc: File script theo dõi của Umami có kích thước cực kỳ nhẹ (chưa tới 2KB), nhỏ hơn hàng chục lần so với GA4, giúp cải thiện đáng kể điểm Core Web Vitals của trang web.
    • Giao diện báo cáo tinh gọn: Thay vì ma trận menu đa cấp của GA4, Umami tổng hợp số liệu cốt lõi (Visitors, Pageviews, Bounce Rate, nguồn traffic, thiết bị, quốc gia) trực quan trên một bảng điều khiển duy nhất.
    • Toàn quyền kiểm soát dữ liệu: Khi triển khai trực tiếp trên hệ thống VPS Linux cá nhân, cơ sở dữ liệu hoàn toàn do bạn kiểm soát mà không lo bên thứ ba khai thác thông tin cho mục đích quảng cáo thương mại.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ tầng tối ưu cho ứng dụng Self-Hosted

    Dịch vụ máy chủ ảo tại Fast Byte cung cấp tài nguyên độc lập, ổ cứng SSD tốc độ cao và đường truyền mạng trong nước ổn định, đáp ứng hoàn hảo nhu cầu vận hành các ứng dụng Docker như Umami với chi phí tối ưu hàng tháng.

    Tham khảo VPS giá rẻ

    Yêu cầu hệ thống và chuẩn bị máy chủ ảo VPS khi cài Umami

    Nhờ khả năng tối ưu hóa tài nguyên xuất sắc của Node.js và PostgreSQL, Umami đòi hỏi mức cấu hình phần cứng rất khiêm tốn. Đối với hầu hết website có quy mô hàng trăm nghìn lượt truy cập hàng tháng, một máy chủ ảo với 1 vCPU và 1GB RAM là đã có thể hoạt động trơn tru.

    • Hệ điều hành khuyến nghị: Phổ biến và dễ quản lý nhất là phân phối hệ điều hành máy chủ Ubuntu (phiên bản 20.04 LTS hoặc 22.04 LTS).
    • Tên miền phụ (Subdomain): Chuẩn bị một tên miền riêng (ví dụ: analytics.yourdomain.com) và tiến hành tạo subdomain và trỏ bản ghi A về địa chỉ IP public của VPS.
    • Quyền truy cập: Đăng nhập VPS với người dùng có đặc quyền root Linux để tiến hành cài đặt các gói hệ thống.

    Hướng dẫn từng bước cài đặt Umami bằng Docker & Docker Compose trên VPS

    Việc đóng gói Umami cùng cơ sở dữ liệu PostgreSQL vào container giúp môi trường vận hành luôn độc lập, sạch sẽ và hạn chế tối đa xung đột phần mềm trên VPS.

    Hướng Dẫn Tự Host Umami Trên VPS

    Bước 1: Cập nhật hệ thống và cài đặt Docker

    Kết nối vào VPS thông qua giao thức dòng lệnh SSH, tiến hành đồng bộ kho phần mềm và cài đặt Docker cùng bộ công cụ điều phối container:

    sudo apt update && sudo apt upgrade -y
    sudo apt install docker.io docker-compose -y

    Bước 2: Soạn thảo cấu hình Docker Compose

    Khởi tạo một thư mục riêng biệt dành cho ứng dụng Umami và mở file cấu hình bằng trình soạn thảo Nano:

    mkdir umami && cd umami
    nano docker-compose.yml

    Dán nội dung cấu hình chuẩn bên dưới vào tệp tin. Cấu hình này sẽ tự động khởi tạo 2 dịch vụ: cơ sở dữ liệu PostgreSQL 15 và ứng dụng Umami kết nối trực tiếp với nhau:

    version: '3'
    services:
      db:
        image: postgres:15-alpine
        environment:
          POSTGRES_DB: umami
          POSTGRES_USER: umami_user
          POSTGRES_PASSWORD: YourSecurePasswordHere
        volumes:
          - pgdata:/var/lib/postgresql/data
        restart: always
      umami:
        image: ghcr.io/umami-software/umami:postgresql-latest
        environment:
          DATABASE_URL: postgresql://umami_user:YourSecurePasswordHere@db:5432/umami
          APP_SECRET: ChangeThisToALongRandomString
        ports:
          - "3000:3000"
        depends_on:
          - db
        restart: always
    volumes:
      pgdata:

    *Lưu ý quan trọng: Thay thế giá trị YourSecurePasswordHere bằng mật khẩu cơ sở dữ liệu đủ mạnh và ChangeThisToALongRandomString bằng một chuỗi ký tự bí mật ngẫu nhiên để đảm bảo an toàn cho token ứng dụng.

    Bước 3: Khởi chạy cụm container

    Sử dụng cú pháp lệnh sau để tải image và đưa các dịch vụ vào trạng thái chạy ngầm (detached mode):

    docker-compose up -d

    Sau khi hoàn tất quá trình tải và khởi động, Umami sẽ lắng nghe các kết nối gửi đến cổng nội bộ 3000 của máy chủ.

    Cách thiết lập Reverse Proxy Nginx và chứng chỉ SSL Let’s Encrypt

    Để đưa trang phân tích hoạt động trên Internet an toàn, bạn nên sử dụng máy chủ web Nginx làm Reverse Proxy chuyển tiếp yêu cầu từ cổng 80/443 vào cổng 3000 của Docker container.

    Trước hết, cài đặt Nginx và cấu hình một virtual host trỏ về tên miền theo dõi:

    sudo apt install nginx -y
    sudo nano /etc/nginx/sites-available/umami

    Khai báo khối cấu hình proxy đơn giản:

    server {
        server_name analytics.yourdomain.com;
    
        location / {
            proxy_pass http://localhost:3000;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;
        }
    }

    Kích hoạt cấu hình và kiểm tra cú pháp trước khi nạp lại dịch vụ:

    sudo ln -s /etc/nginx/sites-available/umami /etc/nginx/sites-enabled/
    sudo nginx -t && sudo systemctl reload nginx

    Tiếp theo, để mã hóa đường truyền dữ liệu giữa trình duyệt của khách truy cập và VPS, hãy thực hiện cài đặt theo hướng dẫn cài SSL Let’s Encrypt bằng Certbot nhằm kích hoạt chứng chỉ HTTPS tự động hoàn toàn miễn phí:

    sudo apt install certbot python3-certbot-nginx -y
    sudo certbot --nginx -d analytics.yourdomain.com

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    VPS cấu hình nhỏ cũng đủ chạy cả hệ thống Umami

    Umami chỉ cần 1 vCPU và 1GB RAM là vận hành tốt với hàng trăm nghìn lượt truy cập mỗi tháng. VPS giá rẻ của Fast Byte sử dụng CPU Intel Gold và ổ SSD NVMe U.2, mức giá từ 50K/tháng — vừa đủ dư địa để bạn chạy thêm website, Nginx hay các dịch vụ nhỏ khác trên cùng một máy chủ mà chi phí vẫn dễ kiểm soát.

    Tham khảo VPS giá rẻ

    Chèn mã theo dõi vào website và kiểm tra dữ liệu realtime

    Sau khi các container chạy ổn định, hệ thống phân tích của bạn đã sẵn sàng hoạt động. Việc còn lại chỉ là đăng nhập, thêm website cần theo dõi và dán đoạn mã script vào mã nguồn.

    Bạn truy cập vào tên miền của mình, đăng nhập bằng tài khoản mặc định (admin / umami) và tiến hành đổi mật khẩu ngay lập tức. Giao diện Umami cho phép bạn tạo mới các mục tiêu theo dõi (Websites) chỉ với vài cú click chuột. Hệ thống sẽ cung cấp cho bạn một đoạn mã script ngắn gọn có dạng như sau:

    <script defer src="https://analytics.yourdomain.com/script.js" data-website-id="your-website-id"></script>

    Hãy copy đoạn mã này và dán vào phần thẻ của website bạn cần theo dõi (có thể là mã nguồn WordPress, Next.js, Nuxt.js hay các trang HTML tĩnh). Ngay lập tức, bạn sẽ thấy các chỉ số truy cập thời gian thực (Realtime) nhảy số trên trang dashboard của Umami.

    Toàn bộ thông tin quan trọng đều được Umami gom về một trang dashboard duy nhất, bao gồm:

    Thông số trên dashboard Ý nghĩa
    Views Tổng lượt xem trang trong khoảng thời gian được chọn
    Visitors Số khách truy cập website (thống kê ẩn danh)
    Bounce Rate Tỷ lệ người dùng rời đi ngay sau khi xem một trang
    Nguồn truy cập Trực quan hóa traffic đến từ kênh nào (tìm kiếm, mạng xã hội, truy cập trực tiếp…)
    Thiết bị Tỷ lệ người dùng truy cập từ desktop, mobile, tablet
    Quốc gia Phân bố vị trí địa lý của người truy cập

    Nếu về sau website của bạn tăng trưởng vượt dự kiến, việc nâng cấp tài nguyên cũng rất đơn giản: chỉ cần chuyển sang gói Cloud VPS mạnh hơn để đảm bảo hiệu năng cho cả Umami và các dịch vụ khác trên máy chủ.

    Nâng cao: theo dõi sự kiện tùy biến (Event Tracking)

    Không chỉ dừng lại ở việc đếm lượt xem trang (Pageviews), Umami còn cho phép bạn theo dõi các hành vi cụ thể của người dùng. Đây là nhóm tính năng giúp bạn hiểu khách hàng hành động thế nào trên website, chứ không chỉ biết họ đến từ đâu.

    Cụ thể, bạn có thể đo lường các tương tác quan trọng như click vào nút mua hàng, tải file tài liệu, hoặc điền form đăng ký. Cách thực hiện rất đơn giản: thêm thuộc tính data-umami-event="Tên-Sự-Kiện" trực tiếp vào các thẻ HTML cần theo dõi. Ví dụ:

    <button data-umami-event="Click-Nut-Mua-Hang">Mua ngay</button>

    Nhờ đó, bạn đo lường tỷ lệ chuyển đổi một cách chính xác ngay trên dashboard quen thuộc của Umami. Nếu muốn tìm hiểu thêm các kỹ thuật vận hành máy chủ và tối ưu website, bạn có thể tham khảo thêm trong thư viện hướng dẫn của Fast Byte.

    Quản trị nâng cao: Public Dashboard và phân quyền Multi-Team

    Phiên bản Umami v2 cung cấp các tính năng quản trị cộng tác mạnh mẽ, cực kỳ tiện ích cho các cá nhân muốn chia sẻ dữ liệu hoặc agency vận hành nhiều dự án cho khách hàng.

    Chia sẻ dashboard công khai (Share URL)

    Bạn có thể bật tính năng công khai dữ liệu truy cập mà người xem không cần đăng nhập tài khoản:

    • Vào Website settings > General và chuyển nút gạt Share URL sang trạng thái ON.
    • Umami sẽ cấp một đường dẫn chia sẻ dạng: https://analytics.yourdomain.com/share/randomkey/sitename.
    • Đường link này rất hữu ích để gửi khách hàng theo dõi traffic của chiến dịch, công khai số liệu cho blog cá nhân nhằm tạo dựng niềm tin, hoặc nhúng trực tiếp bằng iframe vào các trang quản lý nội bộ như Notion và Slite.

    Cơ chế phân quyền Multi-Team cho Agency

    Umami v2 tích hợp sẵn tính năng Teams giúp cô lập dữ liệu theo từng nhóm:

    • Truy cập Settings > Teams > Create team để khởi tạo nhóm làm việc mới.
    • Mời thành viên qua username (người dùng này cần được đăng ký tài khoản trước trên hệ thống Umami).
    • Phân vai trò cụ thể: Owner (quản trị tối cao), Manager (quản lý cài đặt) hoặc Viewer (chỉ xem báo cáo).
    • Chuyển các website tương ứng vào từng team để các thành viên chỉ truy cập được dữ liệu trong phạm vi được chỉ định. Mô hình này hoàn hảo cho các agency quản lý nhiều khách hàng độc lập.

    Chiến lược sao lưu tự động và khôi phục cơ sở dữ liệu Postgres

    Dữ liệu thống kê là tài sản số quan trọng. Để phòng ngừa sự cố phần cứng hoặc lỗi cấu hình, việc thiết lập tác vụ cronjob định kỳ sao lưu Postgres là thao tác bắt buộc.
    Thiết lập lịch Cron tự động sao lưu

    Mở bảng cấu hình cron bằng lệnh crontab -e và thêm cấu hình chạy vào lúc 3 giờ sáng mỗi ngày, đồng thời tự động dọn dẹp các bản sao lưu cũ quá 14 ngày:

    0 3 * * * docker exec umami-db pg_dump -U umami_user umami | gzip > /backup/umami-$(date +\%F).sql.gz
    0 4 * * * find /backup -name "umami-*.sql.gz" -mtime +14 -delete

    Nếu cần mức độ an toàn cao hơn, bạn có thể cấu hình công cụ rclone để tự động đồng bộ thư mục /backup lên các dịch vụ lưu trữ đám mây tương thích S3.

    Quy trình phục hồi dữ liệu khi có sự cố

    Khi cần khôi phục lại cơ sở dữ liệu từ file nén đã backup, bạn thực thi cú pháp lệnh sau:

    gunzip -c /backup/umami-2026-05-22.sql.gz | docker exec -i umami-db psql -U umami_user umami

    Nâng cấp phiên bản và tối ưu hiệu năng khi theo dõi nhiều website

    Cập nhật thường xuyên giúp hệ thống tiếp nhận các tính năng mới và bản vá bảo mật. Đồng thời, khi số lượng website theo dõi tăng dần, bạn cần nắm rõ điểm nghẽn tài nguyên để có phương án tối ưu thích hợp.

    Quy trình nâng cấp Umami lên phiên bản mới

    Phiên bản Umami v2 hiện nay rất ổn định và hiếm khi gặp tình trạng breaking change. Tuy nhiên, bạn vẫn nên sao lưu Postgres trước khi thực hiện chuỗi lệnh nâng cấp:

    cd ~/umami
    docker compose pull
    docker compose down
    docker compose up -d
    docker compose logs -f umami

    Hãy luôn đọc kỹ release note trên GitHub để kiểm tra xem bản cập nhật có yêu cầu migration cấu trúc bảng (schema migration) hay không.

    Đánh giá hiệu năng và xử lý nghẽn phần cứng

    Khi vận hành thực tế trên cấu hình VPS 4GB RAM và 2 vCPU, Umami có khả năng xử lý mượt mà khoảng 50 website với tổng lưu lượng dao động từ 500.000 đến 1.000.000 pageviews/tháng.

    Khi vượt ngưỡng này, điểm nghẽn (bottleneck) đầu tiên thường không nằm ở CPU mà xuất hiện tại tốc độ đọc ghi Disk I/O của container Postgres do phải thực thi liên tục các thao tác insert event. Để mở rộng hiệu năng, bạn có thể tách cơ sở dữ liệu PostgreSQL sang một VPS độc lập chuyên biệt nhằm tối ưu hóa khả năng ghi ổ đĩa.

    Câu hỏi thường gặp khi tự host Umami Analytics (FAQ)

    1. Sử dụng Umami có bị chặn bởi các tiện ích ad-block không?

    Khi bạn tự host Umami dưới tên miền phụ của chính mình và đặt tên file script tùy biến qua Reverse Proxy, phần lớn các bộ lọc chặn quảng cáo phổ biến sẽ không xem đây là script của bên thứ ba, nhờ đó dữ liệu phân tích thu về đầy đủ và chính xác hơn so với Google Analytics.

    2. Cần cấu hình backup dữ liệu PostgreSQL của Umami như thế nào?

    Do toàn bộ dữ liệu nằm trong Docker volume của PostgreSQL, bạn có thể thiết lập lệnh docker exec -t [tên-container-db] pg_dumpall -c -U umami_user > dump.sql và đặt lịch chạy tự động bằng cronjob để định kỳ lưu trữ các bản sao lưu ra không gian lưu trữ ngoài.

    3. Tự host Umami có giới hạn số lượng website được theo dõi không?

    Hoàn toàn không có bất kỳ giới hạn nào về số lượng website, lượt truy cập hay số người dùng quản trị. Năng lực xử lý hoàn toàn phụ thuộc vào dung lượng RAM, CPU và ổ đĩa của máy chủ VPS bạn đang sử dụng.

    Quy trình Tự Host Umami Trên VPS là bước đi chiến lược giúp bạn tối ưu hóa thời gian tải trang, tuân thủ các quy định bảo mật khắt khe và thoát khỏi sự phụ thuộc vào các dịch vụ theo dõi dữ liệu của các hãng công nghệ lớn. Chỉ với vài câu lệnh triển khai Docker đơn giản kết hợp cùng chứng chỉ SSL Let’s Encrypt, bạn đã sở hữu một hạ tầng phân tích độc lập, ổn định và bảo mật toàn diện.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung hướng dẫn trên mang tính chất tham khảo kỹ thuật. Các câu lệnh hệ thống và cấu hình phần mềm có thể thay đổi tùy theo bản phân phối Linux, phiên bản Docker và môi trường mạng thực tế của từng máy chủ. Quản trị viên nên chủ động kiểm tra kỹ lưỡng, sao lưu dữ liệu quan trọng trước khi tiến hành triển khai cho các website đang hoạt động sản xuất.

  • Cách Dùng journalctl Xem & Quản Lý Log systemd Linux Chi Tiết, Toàn Tập

    Cách Dùng journalctl Xem & Quản Lý Log systemd Linux Chi Tiết, Toàn Tập

    Việc sử dụng journalctl để xem và thao tác với nhật ký systemd trên Linux là kỹ năng sống còn giúp quản trị viên gỡ rối tình trạng dịch vụ đột ngột sập nguồn hay ứng dụng báo lỗi ngầm mà không rõ nguyên nhân. Thay vì phải lục tung hàng chục file log phân mảnh truyền thống, công cụ này gom toàn bộ sự kiện hệ thống về một nơi duy nhất. Nắm vững kỹ thuật tra cứu tại ThueVPSGiaRe.vn sẽ giúp bạn vận hành hệ thống luôn mượt mà và an toàn.

    Journal của systemd là gì và tại sao quan trọng?

    Journal của systemd là hệ thống ghi nhật ký tập trung, do tiến trình nền journald thu thập mọi thông báo từ kernel, initrd, các dịch vụ và ứng dụng người dùng, rồi lưu ở định dạng nhị phân để truy vấn linh hoạt. Nhờ đó, bạn có thể xem, lọc và xuất nhật ký bằng một công cụ duy nhất là journalctl, thay vì lần tìm từng tệp log rải rác trên hệ thống.

    Một số ưu điểm nổi bật nhất của systemd nằm ở phần ghi nhật ký tiến trình và hệ thống. Với các công cụ truyền thống, nhật ký thường bị phân tán, do nhiều daemon khác nhau xử lý và khá khó hiểu khi trải rộng trên nhiều ứng dụng. systemd khắc phục điều này bằng giải pháp quản lý tập trung dành cho tất cả các tiến trình kernel và userland, và hệ thống thu thập, quản lý các nhật ký này được gọi là journal.

    • Thu thập tập trung: journald tiếp nhận dữ liệu từ tất cả các nguồn có sẵn, kể cả nhật ký khởi động ban đầu, kernel, initrd cũng như đầu ra chuẩn và lỗi chuẩn của ứng dụng.
    • Hiển thị linh hoạt: quản trị viên có thể xem dữ liệu khởi động từ ba lần khởi động trước đó, hoặc xen kẽ các mục nhật ký theo trình tự thời gian từ hai dịch vụ liên quan để gỡ lỗi sự cố giao tiếp.
    • Xuất nhiều định dạng: vì dữ liệu lưu dạng nhị phân chứ không phải văn bản thuần, bạn có thể xem theo kiểu syslog quen thuộc hằng ngày, hoặc xuất từng mục dưới dạng JSON để lập biểu đồ mà không cần chuyển đổi.
    • Kết hợp hoặc thay thế syslog: journal của systemd đáp ứng hầu hết nhu cầu ghi nhật ký, đồng thời vẫn có thể bổ sung cho cơ chế hiện có, chẳng hạn máy chủ syslog tập trung tổng hợp dữ liệu nhiều máy chủ, kết hợp cùng journal trên từng hệ thống.

    Điểm chính cần ghi nhớ

    • journalctl lọc nhật ký theo phiên khởi động, khoảng thời gian, unit systemd, PID, UID, GID và nhiều tiêu chí khác.
    • Truy xuất theo thời gian bằng --since, --until hoặc biểu thức tương đối như “1 hour ago”, “yesterday”.
    • Hiển thị nhiều định dạng: văn bản thuần, JSON, chế độ chi tiết, giúp tích hợp công cụ bên ngoài.
    • journalctl -f theo dõi log trực tiếp tương tự tail -f.
    • Mặc định log có thể chỉ lưu trong bộ nhớ và mất khi khởi động lại; bật lưu trữ liên tục bằng cách tạo /var/log/journal và cấu hình journald.conf.
    • Quản lý dung lượng bằng --disk-usage, --vacuum-size, --vacuum-time.
    • Đơn giản hóa gỡ lỗi dịch vụ, xác định lỗi, theo dõi truy cập SSH với ngữ cảnh chi tiết từ nhiều lần khởi động.

    Thuê VPS Giá Rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Vận hành dịch vụ ổn định, tra cứu nhật ký mượt mà

    Dịch vụ máy chủ ảo chất lượng cao tại Fast Byte cung cấp ổ cứng NVMe tốc độ cao, giúp các tác vụ đọc ghi chỉ mục log của systemd diễn ra nhanh chóng, loại bỏ hoàn toàn độ trễ I/O khi hệ thống phát sinh tải lớn.

    Tham khảo VPS giá rẻ

    Chuẩn hóa thời gian máy chủ bằng timedatectl trước khi tra cứu log

    Một trong những ưu điểm lớn của nhật ký nhị phân là hiển thị dấu thời gian (timestamp) linh hoạt theo múi giờ địa phương hoặc UTC. Để tránh nhầm lẫn khi đối chiếu thời điểm xảy ra sự cố, bạn cần đảm bảo múi giờ hệ thống đã được đồng bộ chính xác bằng công cụ timedatectl.

    Chuẩn hóa thời gian máy chủ bằng timedatectl
    Chuẩn hóa thời gian máy chủ bằng timedatectl

    Trước tiên, hãy kiểm tra danh sách các múi giờ được hỗ trợ trên hệ điều hành:

    timedatectl list-timezones

    Khi đã xác định được khu vực phù hợp (ví dụ múi giờ Việt Nam hoặc múi giờ máy chủ quốc tế), hãy thiết lập lại bằng lệnh sau:

    sudo timedatectl set-timezone Asia/Ho_Chi_Minh

    Kiểm tra lại trạng thái đồng bộ thời gian và dịch vụ NTP của máy chủ:

    timedatectl status
    
                   Local time: Fri 2021-07-09 14:44:30 EDT
               Universal time: Fri 2021-07-09 18:44:30 UTC
                     RTC time: Fri 2021-07-09 18:44:31
                    Time zone: America/New_York (EDT, -0400)
    System clock synchronized: yes
                  NTP service: active
              RTC in local TZ: no

    Dòng đầu tiên phải hiển thị đúng thời gian hiện tại của bạn.

    Kết quả trả về sẽ hiển thị đầy đủ giờ địa phương (Local time), giờ quốc tế (Universal time), múi giờ hiện tại cũng như trạng thái đồng bộ xung nhịp System clock synchronized: yes. Điều này giúp các mốc thời gian lọc trong journalctl luôn chính xác từng giây.

    Các thao tác đọc nhật ký cơ bản bằng lệnh journalctl

    Lệnh journalctl là cánh cửa duy nhất bạn cần để tương tác với kho nhật ký của systemd. Khi chạy lệnh độc lập không kèm tham số, toàn bộ sự kiện đã ghi nhận sẽ xuất hiện trong trình điều hướng phân trang (mặc định là less), hiển thị từ sự kiện cũ nhất đến mới nhất.

    journalctl
    
    -- Logs begin at Tue 2015-02-03 21:48:52 UTC, end at Tue 2015-02-03 22:29:38 UTC. --
    Feb 03 21:48:52 localhost.localdomain systemd-journal[243]: Runtime journal is using 6.2M (max allowed 49.
    Feb 03 21:48:52 localhost.localdomain systemd-journal[243]: Runtime journal is using 6.2M (max allowed 49.
    Feb 03 21:48:52 localhost.localdomain systemd-journald[139]: Received SIGTERM from PID 1 (systemd).
    Feb 03 21:48:52 localhost.localdomain kernel: audit: type=1404 audit(1423000132.274:2): enforcing=1 old_en
    Feb 03 21:48:52 localhost.localdomain kernel: SELinux: 2048 avtab hash slots, 104131 rules.
    . . .

    Bạn có thể phải cuộn qua hàng trang dữ liệu, thậm chí hàng chục hoặc hàng trăm nghìn dòng nếu journal đã được lưu trữ trên hệ thống trong thời gian dài. Định dạng này sẽ quen thuộc với người dùng syslog, nhưng thực tế nó thu thập từ nhiều nguồn hơn so với triển khai syslog truyền thống.

    Tất cả dấu thời gian hiển thị theo giờ địa phương, và vì giờ địa phương đã được thiết lập đúng ở bước trước, mọi mục nhật ký đều có thông tin này.

    Nếu muốn hiển thị dấu thời gian theo múi giờ UTC, dùng cờ --utc:

    journalctl --utc

    Lọc nhật ký theo thời gian và các lần khởi động

    Truy cập lượng dữ liệu lớn rất hữu ích, nhưng xử lý thủ công thì gần như bất khả thi, vì thế các tùy chọn lọc là tính năng quan trọng nhất của journalctl. Nếu bạn muốn có môi trường riêng để luyện tập an toàn các lệnh bên dưới, có thể tham khảo bảng giá thuê VPS trước khi bắt tay vào thực hiện.

    Hiển thị nhật ký từ phiên khởi động hiện tại

    Công cụ cơ bản nhất là cờ -b, hiển thị toàn bộ mục nhật ký được thu thập kể từ lần khởi động gần nhất:

    journalctl -b

    Nếu hệ thống lưu nhiều hơn một lần khởi động và bạn xem toàn bộ, journalctl sẽ chèn một dòng phân cách mỗi khi máy khởi động lại, giúp bạn tách thông tin theo từng phiên:

    . . .
    
    -- Reboot --
    
    . . .

    Truy cập nhật ký từ các lần khởi động trước

    Một số bản phân phối cho phép lưu thông tin khởi động trước đó theo mặc định, số khác thì tắt. Để bật lưu trữ liên tục, tạo thư mục chứa nhật ký:

    sudo mkdir -p /var/log/journal

    Hoặc chỉnh sửa tệp cấu hình /etc/systemd/journald.conf, trong phần [Journal] đặt Storage=persistent:

    . . .
    [Journal]
    Storage=persistent

    Khi tính năng đã bật, xem danh sách các lần khởi động mà journald biết bằng tùy chọn --list-boots:

    journalctl --list-boots
    
    -2 caf0524a1d394ce0bdbcff75b94444fe Tue 2015-02-03 21:48:52 UTC—Tue 2015-02-03 22:17:00 UTC
    -1 13883d180dc0420db0abcb5fa26d6198 Tue 2015-02-03 22:17:03 UTC—Tue 2015-02-03 22:19:08 UTC
     0 bed718b17a73415fade0e4e7f4bea609 Tue 2015-02-03 22:19:12 UTC—Tue 2015-02-03 23:01:01 UTC

    Mỗi dòng tương ứng một lần khởi động: cột đầu là độ lệch (offset) dùng để tham chiếu nhanh, cột hai là ID khởi động nếu cần tham chiếu tuyệt đối, và hai giá trị thời gian ở cuối cho biết phạm vi phiên. Ví dụ, xem nhật ký từ lần khởi động trước bằng offset -1:

    journalctl -b -1

    Hoặc gọi lại dữ liệu bằng ID khởi động:

    journalctl -b caf0524a1d394ce0bdbcff75b94444fe

    Lọc theo khoảng ngày và giờ tùy chỉnh

    Khi máy chủ hoạt động liên tục với uptime dài, bạn sẽ cần xem nhật ký trong các khoảng thời gian không trùng với lần khởi động. Dùng --since và --until, với giá trị thời gian tuyệt đối theo định dạng YYYY-MM-DD HH:MM:SS. Ví dụ, xem mọi mục kể từ 17:15 ngày 10/01/2015:

    journalctl --since "2015-01-10 17:15:00"

    Nếu bỏ trống một số thành phần, giá trị mặc định sẽ được áp dụng: bỏ ngày thì lấy ngày hiện tại, thiếu giờ thì thay bằng “00:00:00” (nửa đêm), bỏ trường giây thì mặc định “00”:

    journalctl --since "2015-01-10" --until "2015-01-11 03:00"

    journalctl cũng hiểu các giá trị tương đối như “yesterday”, “today”, “tomorrow”, “now”, hoặc dùng dấu “-” / “+” với giá trị số và từ “ago”. Lấy dữ liệu từ hôm qua:

    journalctl --since yesterday

    Nếu nhận thông báo gián đoạn dịch vụ bắt đầu từ 9:00 sáng và kéo dài đến một giờ trước, nhập:

    journalctl --since 09:00 --until "1 hour ago"

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Thực hành journalctl an toàn trên VPS riêng

    Các lệnh xem và dọn dẹp nhật ký tốt nhất nên luyện tập trên môi trường riêng để không ảnh hưởng hệ thống dùng chung. Một chiếc VPS từ Fast Byte với CPU Intel Gold và SSD NVMe U.2 cho phép bạn bật ghi nhật ký liên tục, thử nghiệm bộ lọc và thao tác vacuum mà vẫn giữ chi phí ở mức tối thiểu.

    Tham khảo VPS giá rẻ

    Lọc nhật ký theo dịch vụ, PID, người dùng và mức độ ưu tiên

    Ngoài ràng buộc thời gian, journal của systemd cung cấp nhiều cách lọc nhật ký dựa trên dịch vụ hoặc thành phần mà bạn quan tâm.

    Xem nhật ký theo unit dịch vụ systemd

    Lọc theo unit là cách hữu ích nhất, dùng tùy chọn -u. Ví dụ, xem toàn bộ nhật ký của Nginx:

    journalctl -u nginx.service

    Thường bạn sẽ kết hợp thêm bộ lọc thời gian, chẳng hạn kiểm tra tình trạng dịch vụ hôm nay:

    journalctl -u nginx.service --since today

    Kiểu tập trung này phát huy tác dụng khi xen kẽ bản ghi từ nhiều unit. Nếu Nginx kết nối với unit PHP-FPM để xử lý nội dung động, hợp nhất các mục của cả hai theo thứ tự thời gian bằng cách chỉ định cả hai:

    journalctl -u nginx.service -u php-fpm.service --since today

    Cách này giúp dễ phát hiện tương tác giữa các chương trình và gỡ lỗi cả hệ thống thay vì từng tiến trình riêng lẻ.

    Lọc theo PID, UID hoặc GID

    Nhiều dịch vụ tạo ra nhiều tiến trình con; nếu đã xác định PID cần theo dõi, lọc bằng trường _PID, ví dụ PID 8088:

    journalctl _PID=8088

    Để hiển thị tất cả mục nhật ký của một người dùng hoặc nhóm cụ thể, dùng bộ lọc _UID hoặc _GID. Nếu máy chủ web chạy dưới user www-data, tìm ID người dùng trước:

    id -u www-data
    
    33

    Sau đó dùng ID trả về để lọc:

    journalctl _UID=33 --since today

    Journal có nhiều trường để lọc: một số được truyền từ tiến trình đang được ghi log, số khác do journald tự áp dụng từ thông tin thu thập được. Dấu gạch dưới phía trước (như _PID) cho biết trường thuộc loại thứ hai — journald tự ghi lại và lập chỉ mục PID để lọc sau này. Xem danh sách tất cả các trường bằng lệnh:

    man systemd.journal-fields

    Tùy chọn -F hiển thị tất cả giá trị có sẵn của một trường nhất định, giúp bạn xây dựng bộ lọc. Ví dụ, xem các ID nhóm mà journal có mục nhập:

    journalctl -F _GID
    
    32
    99
    102
    133
    81
    84
    100
    0
    124
    87

    Xem nhật ký theo đường dẫn tệp thực thi

    Bạn cũng có thể lọc bằng cách cung cấp đường dẫn. Nếu đường dẫn trỏ tới tệp thực thi, journalctl hiển thị tất cả mục liên quan đến tệp đó, ví dụ với bash:

    journalctl /usr/bin/bash

    Thông thường, nếu tệp thực thi có unit tương ứng, lọc theo unit sẽ gọn gàng hơn và cung cấp thông tin tốt hơn (bao gồm cả các tiến trình con liên quan), nhưng đôi khi cách này không khả dụng.

    Xem nhật ký kernel với journalctl -k

    Các thông báo kernel, thường thấy trong đầu ra dmesg, cũng có thể truy xuất từ journal. Thêm cờ -k hoặc --dmesg:

    journalctl -k

    Mặc định lệnh hiển thị thông báo kernel từ lần khởi động hiện tại; bạn có thể chỉ định lần khởi động khác bằng cờ chọn khởi động đã giới thiệu, ví dụ lấy thông báo từ năm lần khởi động trước:

    journalctl -k -b -5

    Lọc theo mức độ nghiêm trọng với journalctl -p

    Ghi nhật ký chi tiết thường hữu ích, nhưng khi xem xét, các mục ưu tiên thấp có thể gây xao nhãng. Dùng tùy chọn -p để chỉ hiển thị thông báo ở mức ưu tiên chỉ định trở lên. Ví dụ, chỉ xem mục ghi ở mức lỗi trở lên:

    journalctl -p err -b

    Lệnh này hiển thị mọi thông báo được đánh dấu là lỗi, chí mạng, cảnh báo hoặc khẩn cấp. Journal sử dụng các cấp độ thông báo syslog tiêu chuẩn, bạn có thể dùng tên hoặc giá trị số tương ứng, từ ưu tiên cao nhất đến thấp nhất:

    Giá trị Tên mức độ
    0 khẩn cấp (emergency)
    1 cảnh báo nghiêm trọng (alert)
    2 chí mạng (critical)
    3 lỗi (error)
    4 cảnh báo (warning)
    5 thông báo (notice)
    6 thông tin (info)
    7 gỡ lỗi (debug)

    Số hoặc tên có thể dùng thay thế cho nhau với tùy chọn -p; khi chọn một mức, các thông báo ở mức đó và tất cả mức cao hơn sẽ được hiển thị.

    Tùy chỉnh hiển thị đầu ra nhật ký

    Ngoài việc chọn mục nhập bằng bộ lọc, journalctl còn cho phép điều chỉnh cách hiển thị dữ liệu để phù hợp nhiều nhu cầu khác nhau.

    Kiểm soát độ dài và ký tự hiển thị

    Theo mặc định, toàn bộ mục nhập được hiển thị trong trình xem trang, cho phép nội dung tràn sang bên phải và bạn dùng phím mũi tên phải để xem phần bị ẩn. Nếu muốn rút gọn đầu ra, chèn dấu ba chấm vào chỗ thông tin đã bị cắt, dùng tùy chọn --no-full:

    journalctl --no-full
    
    . . .
    Feb 04 20:54:13 journalme sshd[937]: Failed password for root from 83.234.207.60...h2
    Feb 04 20:54:13 journalme sshd[937]: Connection closed by 83.234.207.60 [preauth]
    Feb 04 20:54:13 journalme sshd[937]: PAM 2 more authentication failures; logname...ot

    Ngược lại, nếu muốn hiển thị toàn bộ thông tin kể cả ký tự không thể in được, dùng cờ -a:

    journalctl -a

    Tắt trình phân trang

    Nếu dự định xử lý dữ liệu bằng các công cụ thao tác văn bản, bạn sẽ muốn xuất kết quả ra đầu ra chuẩn thay vì hiển thị trong trình xem trang. Dùng tùy chọn --no-pager:

    journalctl --no-pager

    Dữ liệu sau đó có thể được chuyển thẳng vào tiện ích xử lý hoặc ghi vào tệp trên ổ đĩa tùy nhu cầu.

    Xuất nhật ký ở các định dạng khác nhau

    Khi phân tích dữ liệu nhật ký, định dạng dễ sử dụng sẽ thuận lợi hơn nhiều. Dùng tùy chọn -o kèm bộ chỉ định định dạng, ví dụ xuất mục nhật ký dưới dạng JSON:

    journalctl -b -u nginx -o json
    
    { "__CURSOR" : "s=13a21661cf4948289c63075db6c25c00;i=116f1;b=81b58db8fd9046ab9f847ddb82a2fa2d;m=19f0daa;t=50e33c33587ae;x=e307daadb4858635", "__REALTIME_TIMESTAMP" : "1422990364739502", "__MONOTONIC_TIMESTAMP" : "27200938", "_BOOT_ID" : "81b58db8fd9046ab9f847ddb82a2fa2d", "PRIORITY" : "6", "_UID" : "0", "_GID" : "0", "_CAP_EFFECTIVE" : "3fffffffff", "_MACHINE_ID" : "752737531a9d1a9c1e3cb52a4ab967ee", "_HOSTNAME" : "desktop", "SYSLOG_FACILITY" : "3", "CODE_FILE" : "src/core/unit.c", "CODE_LINE" : "1402", "CODE_FUNCTION" : "unit_status_log_starting_stopping_reloading", "SYSLOG_IDENTIFIER" : "systemd", "MESSAGE_ID" : "7d4958e842da4a758f6c1cdc7b36dcc5", "_TRANSPORT" : "journal", "_PID" : "1", "_COMM" : "systemd", "_EXE" : "/usr/lib/systemd/systemd", "_CMDLINE" : "/usr/lib/systemd/systemd", "_SYSTEMD_CGROUP" : "/", "UNIT" : "nginx.service", "MESSAGE" : "Starting A high performance web server and a reverse proxy server...", "_SOURCE_REALTIME_TIMESTAMP" : "1422990364737973" }

    Định dạng này hữu ích cho việc phân tích bằng các tiện ích. Nếu muốn hiểu cấu trúc dữ liệu trước khi chuyển cho trình tiêu thụ JSON, dùng json-pretty:

    journalctl -b -u nginx -o json-pretty

    Việc xử lý khối lượng JSON lớn đòi hỏi hiệu năng đọc ghi ổn định, nên nếu thường xuyên phân tích log theo cách này, một máy chủ VPS sử dụng SSD NVMe sẽ giúp trải nghiệm mượt hơn đáng kể. Các định dạng có thể sử dụng bao gồm:

    Định dạng Mô tả
    cat Chỉ hiển thị chính trường thông điệp.
    export Định dạng nhị phân thích hợp để truyền tải hoặc sao lưu.
    json JSON chuẩn, mỗi dòng chứa một mục dữ liệu.
    json-pretty JSON dễ đọc hơn đối với con người.
    json-sse JSON đóng gói tương thích với sự kiện được gửi từ máy chủ (server-sent events).
    short Kiểu xuất syslog mặc định.
    short-iso Kiểu mặc định bổ sung dấu thời gian ISO 8601.
    short-monotonic Kiểu mặc định với dấu thời gian đơn điệu.
    short-precise Kiểu mặc định với độ chính xác đến micro giây.
    verbose Hiển thị mọi trường nhật ký có sẵn, kể cả những trường thường bị ẩn.

    Theo dõi nhật ký systemd theo thời gian thực

    Journalctl mô phỏng cách nhiều quản trị viên dùng lệnh tail để giám sát hoạt động hiện tại hoặc gần đây, và chức năng này được tích hợp sẵn nên bạn không cần chuyển tiếp dữ liệu sang công cụ khác.

    Để hiển thị một số lượng bản ghi nhất định, dùng tùy chọn -n, hoạt động giống hệt tail -n. Mặc định nó hiển thị 10 mục gần đây nhất:

    journalctl -n

    Chỉ định số lượng mục muốn xem bằng cách nhập số ngay sau tùy chọn:

    journalctl -n 20

    Để chủ động theo dõi nhật ký khi chúng đang được ghi, dùng cờ -f, hành xử giống như tail -f:

    journalctl -f

    Để thoát khỏi chế độ theo dõi, nhấn CTRL+C.

    Quản lý và dọn dẹp dung lượng nhật ký

    Sau khi lưu trữ nhật ký liên tục, bạn cần quan tâm đến chi phí dung lượng cũng như cách dọn dẹp nhật ký cũ để giải phóng không gian. Đây là bước đặc biệt quan trọng khi chạy trên gói VPS có dung lượng ổ đĩa hạn chế, vì journal phình to có thể chiếm mất không gian dành cho ứng dụng.

    Kiểm tra dung lượng ổ đĩa mà journal chiếm dụng

    Dùng cờ --disk-usage:

    journalctl --disk-usage
    
    Archived and active journals take up 8.0M in the file system.

    Xóa nhật ký cũ bằng –vacuum-size và –vacuum-time

    Có hai cách thu nhỏ journal (khả dụng từ systemd phiên bản 218 trở lên). Với --vacuum-size, hệ thống xóa các mục cũ cho đến khi tổng dung lượng chiếm dụng đạt đến kích thước yêu cầu:

    sudo journalctl --vacuum-size=1G

    Cách còn lại là thiết lập thời gian giới hạn bằng --vacuum-time; mọi mục cũ hơn thời điểm đó sẽ bị xóa. Ví dụ, chỉ giữ lại các mục từ năm qua:

    sudo journalctl --vacuum-time=1years

    Cấu hình giới hạn dung lượng cho journald

    Bạn có thể đặt giới hạn dung lượng mà journal được phép chiếm dụng bằng cách chỉnh sửa tệp /etc/systemd/journald.conf. Các chỉ thị sau giúp kiểm soát sự tăng trưởng của journal:

    Chỉ thị Ý nghĩa
    SystemMaxUse= Dung lượng đĩa tối đa mà journal có thể dùng trong bộ nhớ lưu trữ lâu dài.
    SystemKeepFree= Dung lượng trống mà journal cần để lại khi thêm mục nhật ký vào bộ nhớ lâu dài.
    SystemMaxFileSize= Kích thước tối đa của từng tệp nhật ký trong bộ nhớ lâu dài trước khi xoay vòng.
    RuntimeMaxUse= Dung lượng tối đa trong bộ nhớ tạm thời (hệ thống tệp /run).
    RuntimeKeepFree= Dung lượng được dành riêng cho mục đích khác khi ghi vào bộ nhớ khả biến (/run).
    RuntimeMaxFileSize= Dung lượng mà một tệp nhật ký riêng lẻ có thể chiếm trong bộ nhớ khả biến (/run) trước khi xoay vòng.

    Bằng cách thiết lập các giá trị này, bạn kiểm soát được cách journald tiêu thụ và bảo tồn dung lượng trên máy chủ. Lưu ý rằng SystemMaxFileSize và RuntimeMaxFileSize nhắm mục tiêu vào các tệp đã lưu trữ để đạt giới hạn, điều này quan trọng khi diễn giải số lượng tệp sau khi thực hiện dọn dẹp.

    Khắc phục sự cố thường gặp với journalctl

    1. Journalctl không hiển thị nhật ký?

    Đôi khi bạn chạy journalctl nhưng chỉ nhận màn hình trống hoặc kết quả vô dụng, tình huống dễ gây bối rối khi đang khắc phục sự cố. Có một số nguyên nhân phổ biến:

    Cơ sở dữ liệu journal trống hoặc thiếu thông tin. Điều này xảy ra trên hệ thống mới cài, môi trường container tối thiểu, hoặc khi hệ thống được cấu hình chỉ lưu nhật ký trong bộ nhớ khả biến (bị xóa khi khởi động lại). Kiểm tra xem ghi nhật ký liên tục có bật hay không bằng cách tìm thư mục journal:

    ls /var/log/journal

    Nếu thư mục không tồn tại hoặc trống, nhật ký của bạn không được lưu giữa các lần khởi động. Khắc phục bằng cách tạo thư mục và khởi động lại dịch vụ journald:

    sudo mkdir -p /var/log/journal
    sudo systemd-tmpfiles --create --prefix /var/log/journal
    sudo systemctl restart systemd-journald

    Dịch vụ ghi nhật ký không hoạt động. Nếu systemd-journald — dịch vụ chịu trách nhiệm thu thập và quản lý dữ liệu nhật ký — gặp lỗi hoặc không khởi động được, nhật ký sẽ trống rỗng. Kiểm tra trạng thái bằng lệnh:

    systemctl status systemd-journald

    Bộ lọc quá hẹp. Vấn đề có thể nằm ở cách bạn truy cập chứ không phải tệp nhật ký: tên unit không tồn tại hoặc phạm vi thời gian quá cụ thể đều có thể trả về kết quả rỗng. Nên chạy journalctl không kèm cờ nào để xác nhận nhật ký đang được thu thập, sau đó dần dần áp dụng bộ lọc.

    Nhật ký đã bị xoay vòng hoặc xóa. Journal tuân theo chính sách lưu giữ dựa trên kích thước và thời gian; nếu nhật ký cũ đã bị công cụ dọn dẹp của systemd-journald xóa, chúng không còn truy cập được nữa. Kiểm tra dung lượng hiện tại bằng journalctl --disk-usage — nếu bạn cấu hình giới hạn kích thước nghiêm ngặt hoặc mới chạy lệnh vacuum thủ công, nhật ký có thể đã bị xóa khỏi cơ sở dữ liệu.

    2. Quyền truy cập bị từ chối khi sử dụng journalctl

    Theo mặc định, quyền truy cập nhật ký hệ thống bị hạn chế cho người dùng root và các thành viên nhóm systemd-journal, nhằm bảo vệ dữ liệu nhạy cảm về hoạt động người dùng, tiến trình hệ thống và lỗi dịch vụ.

    Chạy với đặc quyền cao hơn. Giải pháp đơn giản nhất là thêm sudo trước lệnh để nâng quyền trong suốt lần thực thi:

    sudo journalctl

    Cấp quyền vĩnh viễn qua nhóm. Nếu thường xuyên kiểm tra nhật ký, việc gõ sudo mỗi lần có thể bất tiện; hãy thêm người dùng vào nhóm systemd-journal:

    sudo usermod -aG systemd-journal yourusername

    Nhớ thay yourusername bằng tên đăng nhập thực tế, sau đó đăng xuất và đăng nhập lại để thay đổi có hiệu lực. Từ đó bạn có thể chạy journalctl mà không cần quyền quản trị.

    Xác minh quyền truy cập. Nếu vẫn bị từ chối, kiểm tra quyền tệp/thư mục: thư mục /var/log/journal phải thuộc sở hữu của root và nhóm systemd-journal, với quyền đọc của nhóm được thiết lập đúng:

    sudo chown root:systemd-journal /var/log/journal
    sudo chmod 2755 /var/log/journal

    3. Nhật ký không được lưu giữ sau khi khởi động lại

    Nếu nhật ký biến mất mỗi khi máy khởi động lại, rất có thể hệ thống được cấu hình chỉ lưu nhật ký trong bộ nhớ khả biến — cấu hình mặc định phổ biến trong nhiều bản phân phối Linux và môi trường container được tối ưu dung lượng. Để giữ lại nhật ký, cấu hình journald dùng bộ nhớ lâu dài bằng cách tạo thư mục thích hợp và khởi động lại trình nền ghi nhật ký:

    sudo mkdir -p /var/log/journal
    sudo systemd-tmpfiles --create --prefix /var/log/journal
    sudo systemctl restart systemd-journald

    Nếu thư mục tồn tại mà nhật ký vẫn không được lưu, kiểm tra tệp cấu hình /etc/systemd/journald.conf, tìm chỉ thị Storage= trong phần [Journal]; nếu đang là volatile, đổi thành persistent, lưu tệp và khởi động lại dịch vụ:

    [Journal]
    Storage=persistent

    4. Gỡ lỗi dịch vụ systemd bị lỗi

    Khi một dịch vụ do systemd quản lý không khởi động được hoặc lỗi đột ngột, journalctl trở nên thiết yếu để tìm nguyên nhân gốc rễ: thay vì lục lọi nhiều tệp, journal tổng hợp mọi thông báo liên quan ở một nơi, kèm siêu dữ liệu, dấu thời gian và mức độ ưu tiên.

    Xem xét trạng thái dịch vụ trước tiên bằng lệnh systemctl status, vốn cung cấp ảnh chụp nhanh trạng thái hiện tại cùng các mục nhật ký gần nhất:

    systemctl status nginx.service

    Đầu ra thường chỉ ra ngay vấn đề như đường dẫn cấu hình sai, sự cố quyền truy cập hoặc mã lỗi thoát — thông tin mã thoát và tín hiệu đặc biệt hữu ích để xác định dịch vụ tự lỗi hay bị hệ thống tắt.

    Xem toàn bộ lịch sử nhật ký của dịch vụ bằng cờ -u:

    journalctl -u nginx.service

    Nếu chẩn đoán lỗi xảy ra trong lần khởi động gần nhất, giới hạn đầu ra chỉ trong phiên đó:

    journalctl -u nginx.service -b

    Điều tra bối cảnh lỗi bằng cách đọc các mục nhật ký từ vài phút trước và sau khi sự cố xảy ra, dùng bộ lọc thời gian để thu hẹp phạm vi:

    journalctl -u nginx.service --since "10 minutes ago"

    Để phân tích sâu hơn, bật chế độ hiển thị chi tiết hoặc xem thông báo lỗi mở rộng bằng lệnh sau — nó làm nổi bật các thông báo ưu tiên và lỗi gần đây, hữu ích khi dịch vụ không để lại dấu hiệu rõ ràng trong đầu ra chuẩn:

    journalctl -xe

    5. Giám sát các lần đăng nhập SSH

    SSH là phương thức truy cập chính của hầu hết máy chủ Linux, và cũng vì thế trở thành kênh tấn công vét cạn mật khẩu phổ biến. Khi vận hành dịch vụ VPS của Fast Byte hoặc bất kỳ máy chủ nào, việc giám sát hoạt động SSH bằng journalctl là bước bảo mật cơ bản bạn nên duy trì.

    Xem nhật ký SSH: systemd theo dõi hoạt động SSH trong unit ssh hoặc sshd tùy bản phân phối:

    journalctl -u ssh.service

    hoặc trên một số hệ thống:

    journalctl -u sshd.service

    Các nhật ký này bao gồm lần đăng nhập, lỗi xác thực, đóng phiên và thông báo đàm phán khóa — bước đầu tiên tuyệt vời để xác minh ai đã truy cập máy chủ và vào thời điểm nào.

    Theo dõi thời gian thực khi nghi ngờ xâm nhập hoặc muốn theo dõi đăng nhập đang diễn ra:

    journalctl -f -u ssh.service

    Mỗi sự kiện đăng nhập mới sẽ được in ra ngay khi diễn ra, giúp phát hiện đăng nhập thất bại hoặc các nỗ lực kết nối dồn dập có dấu hiệu độc hại.

    Lọc theo sự kiện đăng nhập cụ thể như mật khẩu không chính xác hoặc kết nối được chấp nhận, bằng cách kết hợp grep:

    journalctl -u ssh.service | grep "Failed password"
    journalctl -u ssh.service | grep "Accepted password"

    Kết hợp thêm bộ lọc thời gian để thu hẹp vào một khoảng cụ thể, cực kỳ hữu ích trong kiểm tra an ninh hoặc điều tra pháp y:

    journalctl -u ssh.service --since "1 hour ago"

    Câu hỏi thường gặp (FAQ)

    1. Tại sao journalctl cần quyền truy cập root?

    Theo mặc định, journalctl yêu cầu quyền root vì nó có thể làm lộ thông tin nhạy cảm thu thập từ dịch vụ hệ thống, thông báo kernel, phiên người dùng và tiến trình nền — bao gồm tên người dùng, biến môi trường, dấu vết lỗi và các lần xác thực.

    Người dùng không phải root vẫn có thể đọc nhật ký nếu thuộc nhóm systemd-journal; thêm người dùng bằng lệnh sudo usermod -aG systemd-journal yourusername, sau đó đăng xuất và đăng nhập lại, miễn là quyền truy cập thư mục nhật ký được cấu hình đúng.

    2. Làm thế nào để lưu nhật ký hệ thống sau khi khởi động lại máy?

    Cần cấu hình systemd-journald dùng bộ nhớ lưu trữ lâu dài thay vì bộ nhớ khả biến (một số bản phân phối mặc định lưu trong /run/log/journal — thư mục tạm bị xóa khi tắt máy). Thực hiện theo bốn bước:

    sudo mkdir -p /var/log/journal
    sudo systemd-tmpfiles --create --prefix /var/log/journal
    sudo systemctl restart systemd-journald

    Tùy chọn, mở /etc/systemd/journald.conf và đảm bảo dòng Storage=persistent được thiết lập. Cấu hình này giúp hệ thống giữ lại dữ liệu nhật ký sau khởi động lại, thuận tiện cho việc kiểm tra và gỡ lỗi sự cố trước đó.

    3. Tôi có thể xóa nhật ký journalctl không?

    Có, bạn xóa hoặc thu nhỏ nhật ký bằng các tùy chọn --vacuum-* do systemd-journald cung cấp:

    sudo journalctl --vacuum-time=2weeks
    sudo journalctl --vacuum-size=500M
    sudo journalctl --vacuum-files=10

    Các lệnh này không xóa nhật ký hiện tại hoặc gần đây trừ khi chúng vượt ngưỡng đã định. Để xóa hoàn toàn, có thể xóa thủ công các tệp trong /var/log/journal, nhưng cách này hiếm khi cần và thường không được khuyến nghị cho hệ thống sản xuất.

    4. Làm thế nào để truy cập nhật ký systemd?

    Dùng lệnh journalctl — công cụ giao tiếp trực tiếp với journal của systemd, nơi lưu mọi nhật ký liên quan đến dịch vụ do systemd quản lý như thông báo khởi động, lỗi unit và lỗi thời gian chạy.

    Xem nhật ký một dịch vụ cụ thể, ví dụ Nginx, bằng journalctl -u nginx.service; có thể kết hợp bộ lọc phiên khởi động, mức độ ưu tiên, phạm vi thời gian hoặc nhiều dịch vụ. Không giống tệp nhật ký truyền thống, journalctl cung cấp cái nhìn thống nhất, được lập chỉ mục từ nhiều nguồn.

    5. Lệnh nào được sử dụng để xem nhật ký systemd?

    Lệnh chính là journalctl, tích hợp sẵn trong systemd và truy cập toàn bộ nhật ký do systemd-journald thu thập: thông báo kernel, nhật ký khởi động sớm, dịch vụ hệ thống và phiên người dùng.

    Một số cách dùng phổ biến: journalctl -u ssh.service (theo dịch vụ), journalctl -p err (theo mức độ ưu tiên), journalctl -f (thời gian thực) — khiến journalctl trở thành công cụ đa năng và toàn diện nhất để xem nhật ký liên quan đến systemd.

    6. Làm thế nào để xem nhật ký kernel thông qua journalctl?

    Dùng cờ -k để lọc đầu ra chỉ gồm thông báo xuất phát từ nhân hệ điều hành:

    journalctl -k

    Lệnh này đặc biệt hữu ích để chẩn đoán sự cố phần cứng, vấn đề mô-đun nhân hoặc lỗi khởi động. Kết hợp -b để xem thông báo từ lần khởi động trước:

    journalctl -k -b -1

    Nhờ đó bạn truy cập nhất quán vào nhật ký nhân, tích hợp với nhật ký từ các dịch vụ khác để hiểu rõ ngữ cảnh.

    7. Sự khác biệt giữa dmesg và journalctl là gì?

    Cả hai đều hiển thị nhật ký nhân hệ điều hành nhưng phục vụ mục đích khác nhau và hoạt động theo cơ chế khác nhau:

    Tiêu chí dmesg journalctl
    Phạm vi Chỉ bộ đệm vòng của nhân (kernel ring buffer) Nhật ký nhân kết hợp toàn bộ nhật ký hệ thống
    Nguồn dữ liệu Chỉ thông báo kernel Kernel, dịch vụ, initrd, phiên người dùng
    Lọc và tra cứu Hạn chế, chủ yếu xem tuần tự Lọc theo thời gian, unit, PID, mức ưu tiên, lần khởi động
    Sau khi khởi động lại Bộ đệm bị ghi đè theo thời gian Giữ được nhật ký các lần khởi động trước nếu bật lưu trữ liên tục

    Qua hướng dẫn trên, có thể thấy việc sử dụng journalctl để xem và thao tác với nhật ký systemd trên Linux không hề phức tạp nếu bạn nắm vững ba trụ cột: bộ lọc thời gian và unit (-b, -u, --since, -p) giúp khoanh vùng đúng dữ liệu cần xem; cấu hình lưu trữ liên tục (/var/log/journal và Storage=persistent) đảm bảo không mất log sau khi khởi động lại; và các lệnh vacuum cùng giới hạn trong journald.conf giữ cho dung lượng ổ đĩa luôn trong tầm kiểm soát.

    Nếu bạn chưa có môi trường để thực hành, hãy bắt đầu với một chiếc VPS giá từ 50K/tháng của Fast Byte — chi phí nhỏ nhưng mang lại nền tảng thực chiến để bạn thành thạo quản trị nhật ký trước khi áp dụng vào hệ thống thực tế.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung bài viết chỉ mang tính chất tham khảo kỹ thuật. Các lệnh, tùy chọn và cấu hình liên quan đến journalctl, systemd-journald có thể thay đổi tùy theo bản phân phối Linux, phiên bản systemd và môi trường triển khai thực tế. Trước khi áp dụng bất kỳ lệnh xóa nhật ký (vacuum) hay chỉnh sửa cấu hình nào cho hệ thống sản xuất, bạn nên kiểm thử trên môi trường thử nghiệm, sao lưu dữ liệu quan trọng và tự đánh giá rủi ro liên quan.

  • Cách Cài Đặt & Bảo Mật Redis Trên Ubuntu Chuẩn Production Cực Dễ A-Z

    Cách Cài Đặt & Bảo Mật Redis Trên Ubuntu Chuẩn Production Cực Dễ A-Z

    Cài đặt và bảo mật Redis trên Ubuntu là việc bạn bắt buộc phải làm trước khi đưa Redis vào chạy thực tế, vì Redis mặc định “tin tưởng” mọi client kết nối đến và không phân quyền truy cập. Bài viết sẽ đi theo từng bước chuẩn: cài Redis qua APT, cấu hình systemd, kiểm tra hoạt động, gắn kết localhost, đặt mật khẩu cho đến đổi tên các lệnh nguy hiểm. Nếu chưa có máy chủ để thực hành, bạn có thể bắt đầu ngay với dịch vụ ThueVPSGiaRe.vn.

    Redis là gì? Vì sao cài xong phải bảo mật ngay?

    Redis là hệ quản trị dữ liệu key-value chạy trên RAM, nổi tiếng nhờ tốc độ xử lý cực nhanh, tính linh hoạt và khả năng hỗ trợ rộng rãi cho các ngôn ngữ lập trình; song vì Redis mặc định chấp nhận mọi kết nối mà không hỏi tên, nên ngay sau khi cài xong trên máy chủ Ubuntu, bạn phải gắn kết nó vào localhost, đặt mật khẩu và khóa các lệnh nguy hiểm trước khi chạy production.

    Redis

    Về bản chất, Redis lưu dữ liệu trong bộ nhớ, giúp truy xuất gần như tức thời, vì vậy nó thường được dùng làm cache, hàng đợi, lưu phiên đăng nhập hoặc nơi đếm số liệu thời gian thực. Nếu bạn chưa nắm nền tảng, hãy đọc qua bài tổng quan về Redis, công dụng và cách so sánh với các giải pháp khác, hoặc tìm hiểu nguyên lý caching hoạt động như thế nào để hiểu vì sao Redis thường đứng ngay trước database của ứng dụng. Trong nhiều trường hợp, người ta cũng cân nhắc Redis cạnh Memcached để chọn công cụ cache phù hợp với kiến trúc hệ thống của mình.

    Chuẩn bị trước khi cài đặt Redis trên Ubuntu

    Trước khi bắt đầu, hãy chắc chắn máy chủ của bạn thỏa mãn các điều kiện sau — đây là các yêu cầu nền tảng trong hướng dẫn gốc, giúp mọi lệnh phía sau chạy đúng như kỳ vọng:

    • Một máy chủ Ubuntu: hướng dẫn gốc thực hiện trên Ubuntu 18.04, các bước cài đặt về cơ bản giữ nguyên trên các phiên bản Ubuntu mới hơn.
    • Tài khoản non-root có quyền sudo: bạn không nên thao tác bằng root trực tiếp. Nếu chưa có, xem nhanh cách tạo user có quyền sudo trên Ubuntu chỉ với vài lệnh.
    • Tường lửa đã được thiết lập: việc mở và chặn port cần được kiểm soát ngay từ đầu, bạn có thể tham khảo cách thiết lập tường lửa UFW trên Ubuntu trước khi cài dịch vụ nào.
    • Truy cập được máy chủ: mọi thao tác dưới đây đều thực hiện qua giao diện dòng lệnh, nếu bạn mới dùng VPS lần đầu, xem trước hướng dẫn đăng nhập VPS Linux qua SSH để kết nối vào máy chủ.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ tầng tối ưu cho Redis Cache & Database

    Redis lưu trữ toàn bộ dữ liệu trên RAM, đòi hỏi tài nguyên máy chủ độc lập và tốc độ đọc ghi đĩa cực nhanh khi ghi snapshot định kỳ. Gói Cloud VPS tại Fast Byte mang lại hiệu năng ổn định, chi phí tối ưu để triển khai cache ứng dụng mượt mà.

    Tham khảo VPS giá rẻ

    Bước 1 — Cài đặt và cấu hình Redis trên Ubuntu

    Trong bước này, bạn sẽ cài Redis từ kho phần mềm chính thức của Ubuntu, sau đó chỉnh sửa file cấu hình để dịch vụ Redis được quản lý bởi systemd — tức là Redis sẽ khởi động cùng máy chủ và có thể được điều khiển bằng các lệnh systemctl.

    Cài đặt Redis từ kho phần mềm

    Redis có sẵn trong kho mặc định của Ubuntu, vì vậy việc cài đặt rất đơn giản. Trước tiên, cập nhật danh sách gói, sau đó tiến hành cài Redis:

    sudo apt update
    sudo apt install redis-server

    Quá trình tải và cài đặt sẽ chạy tự động. Sau khi hoàn tất, Redis đã sẵn sàng trên hệ thống, nhưng chưa tối ưu — bước tiếp theo là chỉnh cấu hình.

    Cấu hình Redis chạy dưới sự quản lý của systemd

    Mở file cấu hình của Redis bằng trình soạn thảo nano:

    sudo nano /etc/redis/redis.conf

    Bên trong file, tìm đến dòng khai báo supervised. Chỉ thị này quyết định hệ thống init nào sẽ quản lý tiến trình Redis dưới dạng dịch vụ. Mặc định, giá trị là no. Vì Ubuntu sử dụng systemd, hãy đổi thành systemd:

    # supervised no
    supervised systemd

    Lưu file và đóng trình soạn thảo. Với thay đổi này, systemd sẽ giám sát Redis, tự động khởi động lại nếu dịch vụ gặp sự cố và khởi chạy Redis cùng hệ điều hành.

    Khởi động lại và kiểm tra trạng thái dịch vụ

    Khởi động lại dịch vụ Redis để cấu hình mới có hiệu lực, sau đó kiểm tra trạng thái:

    sudo systemctl restart redis.service
    sudo systemctl status redis

    Nếu mọi thứ ổn, bạn sẽ thấy kết quả tương tự như sau — chú ý dòng Active: active (running) xác nhận Redis đang chạy bình thường:

    ● redis-server.service - Advanced key-value store
       Loaded: loaded (/lib/systemd/system/redis-server.service; enabled; vendor preset: enabled)
       Active: active (running) since Wed 2018-06-27 18:48:52 UTC; 10s ago
         Docs: http://redis.io/documentation,
               man:redis-server(1)
       Process: 2421 ExecStop=/bin/kill -s TERM $MAINPID (code=exited, status=0/SUCCESS)
     Main PID: 2430 (redis-server)
        Tasks: 4 (limit: 1152)
       CGroup: /system.slice/redis-server.service
               └─2430 /usr/bin/redis-server 127.0.0.1:6379

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Thực hành Redis ngay trên một VPS riêng

    Redis cần một môi trường Linux sạch, quyền sudo và truy cập SSH để bạn làm quen với file cấu hình, systemctl và netstat như trong bài. Một VPS giá rẻ tại Fast Byte với CPU Intel Gold và SSD NVMe U.2 giúp bạn vừa luyện tập vừa deploy ứng dụng thật mà không tốn nhiều chi phí, không phụ thuộc tài nguyên chia sẻ trên shared hosting.

    Tham khảo VPS giá rẻ

    Bước 2 — Kiểm tra Redis hoạt động đúng sau khi cài

    Trước khi tiến hành thay đổi cấu hình bảo mật, hãy xác nhận Redis đang hoạt động đúng. Bạn sẽ tương tác với máy chủ Redis bằng công cụ dòng lệnh redis-cli, thực hiện lưu và đọc dữ liệu, rồi khởi động lại Redis để kiểm tra dữ liệu có được giữ nguyên hay không.

    Kết nối vào Redis đang chạy trên localhost ở cổng 6379:

    redis-cli

    Cửa sổ terminal sẽ chuyển thành prompt của Redis: 127.0.0.1:6379>. Gõ ping để kiểm tra kết nối — Redis sẽ trả lời PONG:

    ping
    PONG

    Tiếp theo, thử lưu một key có giá trị để kiểm tra khả năng ghi:

    set test "It's working!"
    OK

    Đọc lại giá trị vừa lưu:

    "It's working!"

    Khi cả hai thao tác ghi và đọc đều thành công, gõ exit để thoát giao diện Redis, sau đó khởi động lại dịch vụ:

    sudo systemctl restart redis

    Kết nối lại với Redis và kiểm tra key vừa tạo vẫn còn tồn tại sau khi restart:

    redis-cli
    
    127.0.0.1:6379> get test
    "It's working!"

    Nếu giá trị hiển thị đúng như trước khi restart, nghĩa là dữ liệu của bạn được lưu bền — một dấu hiệu tốt cho thấy Redis đang vận hành ổn định. Cuối cùng, thoát khỏi prompt Redis bằng lệnh exit.

    Nếu bạn muốn kiểm tra thêm việc Redis có tự khởi động cùng máy chủ hay không, chạy lệnh sudo systemctl is-enabled redis — kết quả enabled cho biết dịch vụ đã được bật tự khởi động.

    Bước 3 — Gắn kết Redis vào localhost

    Theo mặc định sau cài đặt, Redis chỉ cho phép kết nối từ chính máy chủ đó (localhost, 127.0.0.1). Đây là cấu hình an toàn bạn nên giữ nguyên, trừ khi bạn thực sự hiểu mình đang làm gì.

    Tuy nhiên trên nhiều VPS, do tự tay cài hoặc chỉnh sửa lung tung, Redis có thể bị mở ra để nghe từ mọi địa chỉ IP — một lỗ hổng bị tấn công rất phổ biến: kẻ xấu chỉ cần scan toàn dải port, tìm thấy cổng 6379 rồi gửi lệnh truy cập mà không cần mật khẩu. Nếu bạn nghi ngờ VPS đang bị scan hoặc xâm nhập, hãy đọc bài kiểm tra VPS có bị scan pass hay xâm nhập không để xử lý kịp thời.

    Để kiểm tra, mở lại file cấu hình:

    sudo nano /etc/redis/redis.conf

    Tìm dòng bind và chắc chắn dòng dưới đây đang được bật (không bị đánh dấu # ở đầu):

    bind 127.0.0.1 ::1

    Nếu dòng này đúng như trên, Redis chỉ chấp nhận kết nối từ localhost. Lưu file, rồi khởi động lại dịch vụ để áp dụng:

    sudo systemctl restart redis.service

    Để xác nhận Redis thực sự chỉ lắng nghe trên localhost, dùng lệnh netstat. Nếu máy chủ chưa có công cụ này, cài gói net-tools trước:

    sudo apt install net-tools

    Chạy lệnh kiểm tra port mà Redis đang nghe. Nếu bạn chưa quen, cú pháp lệnh netstat được tổng hợp chi tiết trong bài lệnh netstat và cách dùng từng tham số:

    sudo netstat -tnlp | grep redis

    Kết quả mong đợi sẽ tương tự như sau:

    tcp        0      0 127.0.0.1:6379          0.0.0.0:*               LISTEN      14222/redis-server
    tcp6       0      0 ::1:6379                :::*                    LISTEN      14222/redis-server

    Như vậy Redis chỉ lắng nghe tại 127.0.0.1:6379 và ::1:6379 (localhost, cả IPv4 và IPv6). Nếu không thấy dòng nào xuất hiện, hãy kiểm tra lại dòng bind trong file cấu hình rồi khởi động lại Redis.

    Lưu ý quan trọng: nếu ứng dụng của bạn nằm trên máy khác và cần truy cập Redis từ xa, đừng vội đổi bind ra địa chỉ IP công khai — cách đúng đắn là dùng một kênh kết nối mã hóa như SSH tunnel hoặc VPN. Bạn có thể nắm khái niệm trước qua bài SSH là gì và cách kết nối an toàn.

    Bước 4 — Đặt mật khẩu cho Redis

    Redis cung cấp lớp bảo vệ bằng mật khẩu thông qua chỉ thị requirepass trong file cấu hình. Khi mật khẩu được đặt, bất kỳ client nào muốn thao tác đều phải xác thực bằng lệnh AUTH trước.

    Một điểm cần biết: Redis xử lý mật khẩu cực kỳ nhanh, nhờ đó client có thể xác thực nhiều lần mỗi giây, nhưng điều này cũng có nghĩa mật khẩu dễ bị dò vét (brute-force) nếu quá ngắn. Vì vậy hãy đặt một mật khẩu thật dài và ngẫu nhiên thay vì mật khẩu dễ nhớ.

    Đặt mật khẩu cho Redis
    Đặt mật khẩu cho Redis

    Tạo mật khẩu mạnh

    Chạy lệnh sau để sinh một chuỗi ký tự ngẫu nhiên dài 60 ký tự:

    openssl rand 60 | openssl base64 -A

    Kết quả sẽ là một chuỗi đại loại như (đây chỉ là ví dụ minh họa, bạn phải dùng chuỗi do máy của bạn sinh ra):

    RBOJ9cTNo3rHnbTMZwVzjAvYiuuJy5eRTKbthj9un2XPhmYFlgB6gsZ7hSDAMfdKDCHMvJIeCkE2DjX

    Sao chép chuỗi này lại. Hãy chạy lệnh trên mỗi khi cần một mật khẩu mới — tuyệt đối không dùng mật khẩu mẫu trong bài viết.

    Khai báo mật khẩu trong file cấu hình

    Mở lại file cấu hình Redis:

    sudo nano /etc/redis/redis.conf

    Tìm chỉ thị requirepass. Mặc định dòng này bị chú thích và mang giá trị placeholder foobared. Hãy bỏ dấu # và thay bằng mật khẩu bạn vừa tạo:

    requirepass RBOJ9cTNo3rHnbTMZwVzjAvYiuuJy5eRTKbthj9un2XPhmYFlgB6gsZ7hSDAMfdKDCHMvJIeCkE2DjX

    Lưu file, khởi động lại dịch vụ:

    sudo systemctl restart redis.service

    Kiểm tra mật khẩu đã hoạt động

    Kết nối lại Redis. Lúc này, ngay cả lệnh ping cũng bị từ chối:

    redis-cli
    
    127.0.0.1:6379> ping
    (error) NOAUTH Authentication required.

    Xác thực bằng mật khẩu đã đặt:

    127.0.0.1:6379> auth RBOJ9cTNo3rHnbTMZwVzjAvYiuuJy5eRTKbthj9un2XPhmYFlgB6gsZ7hSDAMfdKDCHMvJIeCkE2DjX
    OK
    
    127.0.0.1:6379> ping
    PONG

    Tiếp tục thử thao tác ghi và đọc sau khi xác thực thành công:

    127.0.0.1:6379> set key1 10
    OK
    
    127.0.0.1:6379> get key1
    "10"

    Nếu bây giờ bạn thoát Redis rồi kết nối lại và chạy get key1, bạn sẽ nhận lỗi NOAUTH — nghĩa là mọi phiên kết nối mới đều phải xác thực lại. Đây chính là hành vi bảo mật mong muốn: mỗi phiên đều phải có mật khẩu thì mới thao tác được dữ liệu.

    Bước 5 — Đổi tên hoặc vô hiệu hóa các lệnh nguy hiểm

    Ngoài xác thực bằng mật khẩu, Redis còn cho phép bạn đổi tên hoặc vô hiệu hóa hoàn toàn một số lệnh. Lợi ích rất rõ ràng: kể cả khi kẻ xấu lọt được vào Redis, họ vẫn không thể chạy những lệnh nguy hiểm nhất để xóa sạch dữ liệu hay chỉnh cấu hình máy chủ.

    Các lệnh thường bị coi là nguy hiểm trong môi trường production gồm FLUSHALL (xóa toàn bộ dữ liệu mọi database), CONFIG (xem và sửa cấu hình), cùng một số lệnh tác động mạnh khác. Việc khóa tất cả hay chỉ khóa một phần là quyết định tùy theo nhu cầu thực tế của ứng dụng — nếu bạn chưa từng dùng lệnh nào, vô hiệu hóa là lựa chọn hợp lý.

    Cách đổi tên lệnh trong file cấu hình

    Trong file /etc/redis/redis.conf, dùng chỉ thị rename-command. Nếu đặt tên mới là chuỗi rỗng "", lệnh đó bị vô hiệu hóa hoàn toàn. Ví dụ, khóa lệnh FLUSHALL:

    rename-command FLUSHALL ""

    Với lệnh bạn vẫn cần dùng nhưng muốn giấu đi (như CONFIG), hãy đổi tên thành một chuỗi dài, ngẫu nhiên và khó đoán — bạn có thể tạo bằng chính lệnh openssl ở Bước 4:

    rename-command CONFIG RBOJ9cTNo3rHnbTMZwVzjAvYiuuJy5eRTKbthj9un2XPhmYFlgB6gsZ7hSDAMfdKDCHMvJIeCkE2DjX

    Lưu file cấu hình và khởi động lại Redis:

    sudo systemctl restart redis.service

    Kiểm tra các lệnh đã bị đổi tên

    Kết nối lại Redis và xác thực bằng mật khẩu như Bước 4, sau đó thử lần lượt:

    redis-cli
    
    127.0.0.1:6379> auth mật_khẩu_của_bạn
    OK
    
    127.0.0.1:6379> ping
    PONG
    
    127.0.0.1:6379> flushall
    (error) ERR unknown command 'flushall'
    
    127.0.0.1:6379> config get requirepass
    (error) ERR unknown command 'config'

    FLUSHALL đã bị xóa hoàn toàn, còn CONFIG đã bị đổi tên nên gọi bằng tên gốc sẽ không còn tồn tại. Để chạy CONFIG, bạn phải gọi bằng tên mới:

    127.0.0.1:6379> auth RBOJ9cTNo3rHnbTMZwVzjAvYiuuJy5eRTKbthj9un2XPhmYFlgB6gsZ7hSDAMfdKDCHMvJIeCkE2DjX
    OK
    
    127.0.0.1:6379> config get requirepass
    1) "requirepass"
    2) "mật_khẩu_bạn_đặt_ở_bước_4"

    Hai lưu ý quan trọng: một là, hãy ghi lại các tên lệnh đã đổi ở nơi an toàn — Redis không có cơ chế mặc định nào liệt kê lại chúng cho bạn; hai là, nếu đổi tên CONFIG, ứng dụng hoặc các công cụ quản trị của bạn cũng phải dùng tên mới đó để tương tác, còn nếu không thì chỉ nên đổi khi thật sự cần thiết.

    Checklist kiểm tra an toàn Redis trước khi lên Production

    Trước khi đưa ứng dụng thực tế vào vận hành, bạn hãy đối chiếu với bảng tổng hợp các hạng mục kiểm tra kỹ thuật sau đây nhằm đảm bảo dịch vụ đã được bảo vệ đa tầng:

    Hạng mục Giá trị đề xuất Mục đích an toàn
    Supervised systemd Đảm bảo Ubuntu quản lý vòng đời tiến trình đồng bộ
    Địa chỉ bind 127.0.0.1 ::1 Chỉ mở kết nối nội bộ, cách ly hoàn toàn khỏi Internet
    Mật khẩu xác thực Chuỗi ngẫu nhiên dài (từ 50 ký tự trở lên) Chống tấn công brute-force tốc độ cao
    Đổi tên lệnh Tắt FLUSHALL, đổi tên CONFIG Ngăn chặn xóa sạch database và can thiệp file máy chủ
    Kế hoạch sao lưu Sao lưu tệp dump.rdb định kỳ Kết hợp cùng giải pháp sao lưu dữ liệu VPS định kỳ đề phòng sự cố phần cứng

    Câu hỏi thường gặp khi cài đặt và bảo mật Redis trên Ubuntu

    Redis vừa cài xong có an toàn để dùng ngay không? Không. Redis mặc định tin tưởng mọi client kết nối đến, không có phân quyền. Bộ ba cấu hình trong bài — bind localhost, mật khẩu requirepass và đổi tên lệnh nguy hiểm — chính là lớp bảo vệ tối thiểu trước khi đưa Redis vào sử dụng thật.

    Có nên mở port 6379 ra internet để truy cập từ xa? Không nên. Cách an toàn là giữ Redis nghe trên localhost và truy cập từ xa qua SSH tunnel hoặc VPN; nếu cần, bổ sung thêm tường lửa chỉ cho phép IP tin cậy kết nối.

    Vô hiệu hóa hay đổi tên lệnh tốt hơn? Nếu bạn và ứng dụng không bao giờ dùng lệnh đó, vô hiệu hóa bằng chuỗi rỗng là gọn nhất. Nếu vẫn cần dùng thỉnh thoảng, đổi tên thành chuỗi dài ngẫu nhiên để chỉ mình bạn biết cách gọi.

    Quên tên lệnh đã đổi thì làm sao? Mở lại file redis.conf, tìm các dòng rename-command để xem tên mới. Vì vậy hãy lưu sẵn danh sách này ở nơi an toàn ngay khi cấu hình.

    Bảo mật Redis xong thì làm gì tiếp cho máy chủ? Redis chỉ là một mảnh ghép. Hãy nhìn tổng thể bằng quy trình bảo mật VPS 10 bước chống hacker để đảm bảo các dịch vụ khác trên máy chủ cũng được khóa chặt tương tự.

    Tổng kết: Cài đặt và bảo mật Redis trên Ubuntu chưa bao giờ khó

    Như vậy, cài đặt và bảo mật Redis trên Ubuntu chỉ gồm 5 bước chính: cài Redis qua APT và cấu hình supervised systemd, kiểm tra hoạt động bằng redis-cli, gắn kết vào localhost, đặt mật khẩu dài và ngẫu nhiên, cuối cùng là đổi tên hoặc vô hiệu hóa các lệnh như FLUSHALL và CONFIG. Ba lớp bảo vệ này xếp tầng lên nhau, giúp Redis an toàn ngay cả trong môi trường production.

    Lớp bảo vệ Cấu hình liên quan Tác dụng
    Bind localhost bind 127.0.0.1 ::1 Chỉ máy chủ mới kết nối được vào Redis
    Mật khẩu requirepass Bắt mọi phiên kết nối phải xác thực bằng AUTH
    Đổi tên lệnh rename-command Khóa hoặc giấu các lệnh xóa dữ liệu, sửa cấu hình

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Nội dung trên được biên soạn cho mục đích tham khảo kỹ thuật. Các câu lệnh, đường dẫn tệp tin và thông số cấu hình có thể có sự khác biệt tùy theo phiên bản phân phối Ubuntu, phiên bản Redis Server hoặc chính sách mạng của từng nhà cung cấp hạ tầng. Quản trị viên nên chủ động kiểm thử, tạo bản sao lưu dữ liệu đầy đủ và đánh giá rủi ro an toàn thông tin trước khi áp dụng trên môi trường thực tế (production).

  • Hướng Dẫn Sử Dụng Lệnh XZ Nén File Trong Linux Không Mất Gốc, Siêu Nhanh

    Hướng Dẫn Sử Dụng Lệnh XZ Nén File Trong Linux Không Mất Gốc, Siêu Nhanh

    Nén XZ trong Linux là một trong những giải pháp tối ưu dung lượng tệp tin hiệu quả nhất hiện nay khi bạn cần lưu trữ dữ liệu lớn hoặc tạo các bản sao lưu dài hạn trên máy chủ. Việc ổ đĩa bị quá tải do tệp nhật ký (log) hoặc file sao lưu phình to luôn là cơn đau đầu thường trực của quản trị viên; lúc này xz giúp thu gọn kích thước triệt để hơn hẳn gzip truyền thống mà không làm suy giảm tính toàn vẹn của dữ liệu. Nếu bạn đang vận hành website hoặc ứng dụng trên hạ tầng máy chủ của ThueVPSGiaRe.vn, việc thành thạo công cụ này sẽ giúp tiết kiệm tối đa tài nguyên lưu trữ và băng thông truyền tải.

    1. Tổng quan về công cụ nén XZ và cú pháp cơ bản

    Lệnh xz là tiện ích dòng lệnh sử dụng thuật toán nén LZMA/LZMA2, được thiết kế để tạo ra các tệp có kích thước nhỏ hơn đáng kể so với gzip hoặc bzip2. Công cụ này chấp nhận tiêu hao thêm một chút thời gian xử lý của CPU để đổi lấy tỉ lệ nén vượt trội, chính vì vậy xz thường xuyên được chọn để đóng gói mã nguồn Linux kernel, các gói cài đặt hệ điều hành và lưu trữ các kho snapshot dài hạn.

    Cú pháp chuẩn của lệnh nén xz rất trực quan:

    xz [tùy_chọn] [tên_tệp]

    Lưu ý cốt lõi về cơ chế hoạt động: Khác với lệnh zip trên Windows hay một số công cụ nén khác, theo mặc định lệnh xz sẽ xóa bỏ tệp tin gốc sau khi quá trình nén hoàn tất và thay thế bằng tệp có đuôi mở rộng .xz. Nếu không nắm rõ điều này khi thao tác qua các lệnh Linux cơ bản, bạn có thể vô tình làm gián đoạn các luồng đọc tệp đang diễn ra trên hệ thống.

    • Đặc tính thuật toán: Sử dụng LZMA2 cho khả năng thu nhỏ kích thước tệp tối đa.
    • Hành vi mặc định: Tệp nguồn bị xóa tự động sau khi tạo xong file .xz trừ khi có tham số giữ lại.
    • Phạm vi nén: Chỉ thao tác trên từng tệp đơn lẻ (dòng byte), không thể nén trực tiếp cả thư mục chứa nhiều file nếu không kết hợp cùng công cụ tar.

    2. Cách cài đặt xz trên các bản phân phối Linux

    Hầu hết các bản phân phối phổ biến đều có sẵn xz trong kho phần mềm chính thức, bạn không cần phải thêm repository của bên thứ ba. Sau khi thực hiện kết nối SSH vào máy chủ Linux, bạn có thể dùng trình quản lý gói tương ứng để cài đặt nhanh chóng.

    Cài đặt lệnh xz trên Linux

    Tùy theo hệ điều hành đang sử dụng, bạn chọn câu lệnh phù hợp bên dưới:

    # Dành cho Ubuntu / Debian
    sudo apt update && sudo apt install xz-utils
    
    # Dành cho RHEL / Rocky Linux / AlmaLinux / Fedora
    sudo dnf install xz
    
    # Dành cho Arch Linux
    sudo pacman -S xz

    Sau khi cài đặt xong, bạn có thể kiểm tra phiên bản hoạt động bằng lệnh xz --version. Kết quả hiển thị tiêu chuẩn sẽ tương tự như sau:

    xz (XZ Utils) 5.6.2
    liblzma 5.6.2

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Tối ưu dung lượng lưu trữ trên VPS Linux

    Dù bạn chạy web server hay chứa nhiều bản sao lưu cơ sở dữ liệu lớn, việc kết hợp công cụ nén xz với cấu hình máy chủ ảo hiệu năng cao tại Fast Byte sẽ giúp hệ thống luôn mượt mà, hạn chế triệt để nguy cơ tràn ổ đĩa với mức chi phí đầu tư tiết kiệm nhất.

    Tham khảo VPS giá rẻ

    3. 12 ví dụ thực hành nén lệnh xz trên Linux chi tiết từ A-Z

    Dưới đây là 12 trường hợp sử dụng thực tế nhất được phân bổ từ cơ bản đến nâng cao, bám sát các nhu cầu xử lý file nén thường ngày trên hệ điều hành Linux.

    cách nén lệnh xz trên Linux

    Ví dụ 1: Nén tệp tin cơ bản với tham số mặc định

    Khi không khai báo tùy chọn nào, lệnh xz sẽ tự động áp dụng mức nén mặc định là cấp độ 6. Mức này đem lại sự cân bằng rất tốt giữa tốc độ xử lý và dung lượng file đầu ra.

    xz backup.log

    Kiểm tra danh sách tệp với lệnh ls:

    backup.log.xz

    Tệp gốc backup.log đã không còn và được thay thế bằng backup.log.xz.

    Ví dụ 2: Giữ lại tệp gốc sau khi nén với cờ -k

    Nếu bạn chuẩn bị nén một file cấu hình hoặc tài liệu đang cần sử dụng song song, hãy thêm cờ -k (viết tắt của keep) để ngăn xz xóa file nguồn.

    xz -k config.json

    Kết quả hiển thị sau khi chạy:

    config.json  config.json.xz

    Ví dụ 3: Giải nén tệp .xz về trạng thái ban đầu

    Để giải phóng dữ liệu từ định dạng .xz, bạn dùng cờ -d hoặc sử dụng lệnh tương đương là unxz:

    xz -d backup.log.xz

    Tệp nén backup.log.xz sẽ được bung ra thành backup.log như cũ.

    Ví dụ 4: Kiểm tra tỉ lệ nén mà không cần giải nén với cờ -l

    Thay vì phải giải nén tệp ra đĩa rồi đo dung lượng, cờ -l (list) cho phép xem chi tiết kích thước trước và sau nén, tỉ lệ tiết kiệm và mã kiểm tra tính toàn vẹn.

    xz -l config.json.xz

    Kết quả hiển thị:

    Strms  Blocks   Compressed Uncompressed  Ratio  Check   Filename
        1       1     412 B      1,240 B        0.332  CRC64   config.json.xz

    Ví dụ 5: Tùy chỉnh mức độ nén từ 0 đến 9

    Các mức nén của xz dao động từ -0 (nén nhanh nhất nhưng tệp dung lượng lớn hơn) đến -9 (nén chặt nhất, tiết kiệm dung lượng tối đa nhưng tiêu tốn thời gian và RAM). Bạn có thể kiểm chứng sự khác biệt qua ví dụ sau:

    cp access.log access_fast.log
    cp access.log access_best.log
    xz -0 access_fast.log
    xz -9 access_best.log

    So sánh hai mức bằng cờ -l:

    xz -l access_fast.log.xz access_best.log.xz
    Strms  Blocks   Compressed Uncompressed  Ratio  Check   Filename
        1       1     11.4 MiB    41.2 MiB     0.277  CRC64   access_fast.log.xz
        1       1     8.9 MiB    41.2 MiB     0.216  CRC64   access_best.log.xz

    Mẹo Production: Đối với các tác vụ lên lịch backup tự động với cronjob chạy vào đêm khuya khi hệ thống rảnh rỗi, mức 9 kết hợp cùng chế độ extreme là lựa chọn lý tưởng. Ngược lại, nếu tiến trình chạy trong giờ làm việc ban ngày, bạn chỉ nên giữ mức nén mặc định để tránh đẩy CPU lên ngưỡng cảnh báo.

    Ví dụ 6: Ép tỉ lệ nén tối đa với chế độ Extreme (-e)

    Thêm cờ -e vào sau mức nén để kích hoạt chế độ nén sâu, lệnh sẽ dành thêm tài nguyên tính toán nhằm tối ưu kích thước nhỏ hơn nữa ở cùng cấp độ. Thông thường tùy chọn này được ghép chung với -9 đối với các bản dump database lưu trữ dài hạn.

    xz -9e database-dump.sql

    Ví dụ 7: Tăng tốc nén bằng đa luồng CPU với -T

    Mặc định ban đầu xz chỉ hoạt động trên một nhân CPU đơn lẻ, khiến quá trình nén các tệp tin hình ảnh ổ đĩa hoặc cơ sở dữ liệu hàng chục GB diễn ra khá chậm. Bằng cách thêm -T 0, công cụ sẽ tự động nhận diện và tận dụng toàn bộ số nhân CPU có sẵn trên máy chủ.

    time xz -T 0 -k vmdisk.img

    Kết quả đo đạc từ lệnh time:

    real    1m42.311s
    user    11m8.902s
    sys     0m4.115s

    Thông số user time lớn hơn rất nhiều so với real time minh chứng rõ ràng rằng toàn bộ các lõi CPU đã cùng tham gia tính toán song song, rút ngắn thời gian chờ đợi đáng kể. Nếu đang xử lý các file quá nặng, bạn nên kết hợp dùng tiện ích screen duy trì phiên làm việc để tránh bị rớt tiến trình khi mất kết nối mạng giữa chừng.

    Ví dụ 8: Kết hợp tar và xz để đóng gói cả thư mục (.tar.xz)

    Bản thân lệnh xz không thể gom cấu trúc cây thư mục. Để nén toàn bộ thư mục website hoặc tài liệu, bạn kết hợp công cụ tar với cờ chữ J in hoa để định tuyến dữ liệu trực tiếp qua xz.

    tar -cJf website-backup.tar.xz /var/www/html

    Kiểm tra tệp nén đã tạo:

    tar: Removing leading '/' from member names
    -rw-r--r-- 1 root root 214M Aug 25 09:12 website-backup.tar.xz

    Phương pháp này hoàn toàn thích hợp khi triển khai quy trình sao lưu dữ liệu máy chủ tự động trước mỗi đợt nâng cấp mã nguồn.

    Ví dụ 9: Giải nén gói tệp tin .tar.xz với tùy chọn -xJf

    Ngược lại với quá trình tạo gói, bạn sử dụng cờ x để trích xuất nội dung, giữ nguyên cờ J cho định dạng xz và cờ -C để chỉ định thư mục đích tiếp nhận file giải nén:

    tar -xJf website-backup.tar.xz -C /restore

    Ví dụ 10: Đọc nội dung tệp nén ra stdout mà không ghi xuống đĩa

    Khi bạn cần lọc nhanh một chuỗi lỗi mã 500 từ tệp nhật ký access.log.xz mà không muốn tốn công bung file chiếm thêm bộ nhớ đĩa, hãy sử dụng xzcat hoặc tổ hợp xz -dc đưa luồng dữ liệu sang lệnh grep:

    xzcat access.log.xz | grep "500"

    Các dòng khớp điều kiện sẽ được in ngay lập tức trên màn hình console:

    10.0.0.14 - - [25/Aug/2026:03:12:09] "GET /checkout HTTP/1.1" 500 312
    10.0.0.22 - - [25/Aug/2026:03:14:51] "POST /api/order HTTP/1.1" 500 118

    Ví dụ 11: Kiểm tra tính toàn vẹn của tệp nén (-t)

    Trước khi xóa bản gốc hoặc chuyển gói dữ liệu qua máy chủ khác, hãy chạy cờ -t kèm -v (verbose) để bảo đảm cấu trúc file không bị hỏng hóc hay lỗi bit checksum trong quá trình ghi:

    xz -tv website-backup.tar.xz

    Kết quả phản hồi an toàn:

    website-backup.tar.xz (1/1)
      100 %       214.3 MiB / 812.6 MiB = 0.264
    
    website-backup.tar.xz: OK

    Ví dụ 12: Lỗi thường gặp khi nén trực tiếp thư mục bằng xz

    Người dùng mới chuyển từ môi trường zip thường gõ trực tiếp lệnh xz nhắm vào thư mục và gặp lỗi báo bỏ qua ngay lập tức:

    xz /var/www/html

    Hệ thống thông báo:

    xz: /var/www/html: Is a directory, skipping

    Giải thích nguyên nhân: xz không được tạo ra với khái niệm quản lý cấu trúc cây thư mục hay metadata tập tin, nó chỉ xử lý một dòng byte liên tục. Do đó, bạn bắt buộc phải gói thư mục thành một file tarball thông qua tar trước rồi mới nén lại như hướng dẫn ở Ví dụ 8.

    4. Bảng tổng hợp các tùy chọn lệnh xz phổ biến

    Để thuận tiện cho việc tra cứu nhanh khi cấu hình script tự động hóa trên máy chủ, dưới đây là bảng đối soát các tùy chọn hay dùng nhất của tiện ích xz:

    Tùy chọn (Flag) Chức năng chi tiết Ví dụ áp dụng
    -k, –keep Giữ lại tệp gốc, không xóa sau khi nén hoặc giải nén xz -k app.log
    -d, –decompress Chuyển sang chế độ giải nén tệp .xz xz -d archive.xz
    -l, –list Xem thông số tỉ lệ nén, dung lượng trước/sau xz -l data.xz
    -0 … -9 Thiết lập mức nén (0 thấp nhất, 9 cao nhất, mặc định 6) xz -9 sql.dump
    -e, –extreme Bật chế độ tối ưu hóa cực hạn, dùng nhiều CPU hơn xz -9e kernel.bin
    -T, –threads Chỉ định số luồng CPU (dùng -T 0 để kích hoạt toàn bộ) xz -T 0 data.raw
    -t, –test Kiểm tra tính toàn vẹn của tệp nén theo mã checksum xz -tv backup.xz
    -c, –stdout Xuất dữ liệu nén/giải nén ra đầu ra chuẩn stdout xz -dc file.xz | grep “err”

    5. Những sai lầm phổ biến và lưu ý khi chạy môi trường Production

    Khi triển khai nén XZ trên môi trường dịch vụ trực tiếp, bạn cần chủ động kiểm soát tài nguyên để tránh làm sập các ứng dụng lân cận. Dưới đây là những điểm cốt tử cần ghi nhớ:

    • Coi chừng ngốn sạch bộ nhớ RAM: Ở cấp độ -9 hoặc -9e, thuật toán LZMA2 đòi hỏi dung lượng RAM giải thuật rất lớn (lên tới 600MB – 1GB RAM cho mỗi luồng nén). Nếu máy chủ chỉ có 1-2GB RAM mà bạn kích hoạt đa luồng -T 0, kernel Linux có thể kích hoạt cơ chế OOM Killer tắt ngang web server hoặc MySQL. Nếu máy chủ báo thiếu bộ nhớ liên tục, bạn hãy cân nhắc mở rộng dung lượng ổ cứng trên Linux để tăng thêm phân vùng swap dự phòng.
    • Quên thêm cờ giữ file gốc (-k): Như đã nhấn mạnh, tệp nguồn sẽ bị xóa ngay khi xz hoàn thành. Nếu ứng dụng backend đang tiếp tục ghi nối dữ liệu vào file log đó, bạn sẽ làm mất các dòng nhật ký quan trọng.

    • Cân nhắc tốc độ nén so với gzip: Mặc dù xz cho dung lượng nhỏ hơn gzip từ 15% đến 30%, nhưng thời gian nén lại lâu hơn. Nếu bạn cần chuyển dữ liệu qua mạng ngay tức khắc thông qua công cụ sao chép như đồng bộ tệp tin rsync, mức nén thấp của gzip hoặc xz mức 0-2 sẽ thực dụng hơn nhiều.
    • Chọn cấu hình hạ tầng thích hợp: Với các tác vụ nén nén sâu định kỳ nhiều tệp dung lượng khủng, việc chạy trên các hệ thống quản trị VPS Linux sử dụng vi xử lý đa nhân xung cao sẽ cắt giảm phân nửa thời gian xử lý tổng thể.

    6. Câu hỏi thường gặp (FAQ) về nén XZ trong Linux

    Nén xz khác gì so với gzip và bzip2?

    Gzip nén nhanh nhất nhưng tệp tạo ra có kích thước lớn nhất trong ba loại. Bzip2 nằm ở phân khúc trung gian nhưng hiện nay ít được ưa chuộng. Trong khi đó, xz có tỉ lệ nén vượt trội nhất, tạo ra file nén có dung lượng nhỏ nhất nhờ thuật toán LZMA2 hiện đại, đổi lại sẽ tiêu tốn nhiều thời gian CPU hơn trong giai đoạn nén.

    Tốc độ giải nén tệp .xz có chậm như lúc nén không?

    Hoàn toàn không. Tốc độ giải nén của xz cực kỳ nhanh và chỉ tốn một phần nhỏ bộ nhớ RAM so với lúc thực hiện nén. Đây chính là lý do các bản phân phối Linux thường dùng xz để đóng gói file cài đặt (package) và nhân hệ điều hành: nhà phát hành nén một lần nhưng hàng triệu người dùng tải về giải nén cực nhanh.

    Làm sao để biết một tệp nén .tar.xz chứa những file gì bên trong?

    Bạn có thể liệt kê toàn bộ danh sách tệp bên trong kho nén mà không cần giải nén ra đĩa bằng câu lệnh tar -tvf ten_tep.tar.xz.

    Tổng kết về kỹ thuật nén XZ trên máy chủ Linux

    Thành thạo phương pháp nén XZ trong Linux kết hợp cùng lệnh tar là bước đi cơ bản nhưng vô cùng quan trọng giúp bạn kiểm soát triệt để dung lượng ổ cứng, tăng cường hiệu quả lưu trữ sao lưu và tối ưu hóa chi phí vận hành máy chủ. Hãy luôn nhớ thêm cờ -k khi cần bảo vệ file gốc, tận dụng -T 0 để tăng tốc đa nhân và chọn đúng mức nén phù hợp với khung giờ hoạt động của hệ thống.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng biệt với toàn quyền root cao nhất.

    Xem bảng giá VPS

    Lưu ý kỹ thuật: Toàn bộ nội dung hướng dẫn trên mang tính chất tham khảo thực hành. Cú pháp câu lệnh và lượng tài nguyên RAM/CPU tiêu thụ thực tế có thể thay đổi tùy theo bản phân phối Linux, phiên bản gói phần mềm xz-utils và thông số phần cứng cụ thể. Quản trị viên nên thử nghiệm trước trên môi trường staging hoặc các tệp tin thử nghiệm trước khi áp dụng đồng loạt vào hệ thống production.

  • Cách Kiểm Tra Port Linux Đang Lắng Nghe Dùng ss, netstat & lsof Dễ Dàng

    Cách Kiểm Tra Port Linux Đang Lắng Nghe Dùng ss, netstat & lsof Dễ Dàng

    Kiểm tra port đang lắng nghe trong Linux là kỹ năng quản trị bắt buộc khi bạn gặp sự cố xung đột cổng mạng, ứng dụng web không khởi động được hoặc nghi ngờ dịch vụ lạ đang chạy ngầm trên máy chủ. Thay vì loay hoay đoán lỗi trong vô vọng, việc nắm vững các lệnh chẩn đoán socket sẽ giúp bạn khoanh vùng tiến trình chính xác chỉ sau vài giây. 

    Bài viết này sẽ hướng dẫn bạn cách sử dụng ba công cụ phổ biến trong hệ điều hành Linux gồm ss, netstat và lsof để truy vấn danh sách dịch vụ cùng cổng mạng đang mở. Để thuận tiện cho việc thao tác dòng lệnh, bạn cũng có thể tham khảo thêm các câu lệnh Linux cơ bản hay dùng trên máy chủ.

    1. Bản Chất Cổng Lắng Nghe (Listening Port) Và Cơ Chế Hoạt Động

    Một cổng lắng nghe (listening port) là điểm cuối giao tiếp được hệ điều hành cấp phát cho ứng dụng nhằm chờ đợi các yêu cầu kết nối từ mạng nội bộ hoặc Internet. Điểm cuối này luôn gắn chặt với số hiệu cổng, giao thức truyền tải và địa chỉ IP cụ thể mà tiến trình liên kết.

    • Định danh kết nối: Mỗi listening port được xác định bởi 3 yếu tố: số cổng (port number), địa chỉ IP liên kết và loại giao thức truyền thông như TCP hoặc UDP (tìm hiểu thêm về mô hình giao thức TCP/IP để nắm rõ cách dữ liệu đóng gói ở tầng mạng).
    • Ý nghĩa địa chỉ IP lắng nghe: Dịch vụ chỉ liên kết tới địa chỉ localhost (127.0.0.1) sẽ chỉ cho phép các tiến trình nội bộ trên cùng máy chủ giao tiếp. Ngược lại, khi liên kết vào 0.0.0.0 (IPv4) hoặc [::] (IPv6), ứng dụng sẽ tiếp nhận kết nối qua mọi giao diện mạng của máy chủ.
    • Trạng thái socket và khả năng tiếp cận thực tế: Việc cổng hiển thị listening cục bộ không đồng nghĩa máy khách từ xa truy cập được. Tường lửa và bộ định tuyến vẫn có quyền chặn gói tin; muốn máy khách bên ngoài kết nối được, bạn cần chủ động mở port trên máy chủ thông qua các quy tắc firewall tương ứng.
    • Quy tắc độc quyền liên kết cổng: Thông thường, hai tiến trình riêng biệt không thể cùng lúc bind độc lập vào cùng một IP, giao thức và cổng. Ví dụ, nếu Apache đang chiếm cổng 80/443, việc khởi động thêm phần mềm máy chủ web Nginx sẽ lập tức phát sinh lỗi vì cổng dịch vụ đã bị chiếm hữu.

    Thuê VPS giá rẻ

    CPU Intel Gold, SSD NVMe U.2, giá từ 50K/tháng

    Hạ Tầng Riêng Biệt, Quản Trị Cổng Mạng Toàn Quyền

    Khi chạy nhiều ứng dụng như Web Server, Database hay bot tự động, việc kiểm soát xung đột port và bảo mật kết nối là điều cốt lõi. Dịch vụ VPS giá rẻ tại Fast Byte cấp quyền root tuyệt đối, tài nguyên độc lập giúp bạn tự do tùy biến mở, chặn hoặc đổi port theo chuẩn an toàn kỹ thuật.

    Tham khảo VPS giá rẻ

    2. Kiểm Tra Cổng Đang Lắng Nghe Nhanh Chóng Bằng Lệnh ss

    ss (Socket Statistics) là giải pháp hiện đại được thiết kế để thay thế hoàn toàn công cụ tiền nhiệm netstat. Lệnh này giao tiếp trực tiếp với không gian nhân Linux, mang lại tốc độ hiển thị cực nhanh và có sẵn trên hầu hết các bản phân phối Linux hiện đại.

    Kiểm Tra Cổng Đang Lắng Nghe Bằng Lệnh ss

    Để quét nhanh danh sách toàn bộ các cổng TCP và UDP đang mở ở chế độ lắng nghe, bạn hãy nhập câu lệnh sau trên terminal:

    sudo ss -tunlp

    Ý nghĩa chi tiết của các cờ lệnh:

    • -t: Chỉ hiển thị các socket thuộc giao thức TCP.
    • -u: Chỉ hiển thị các socket thuộc giao thức UDP.
    • -n: Hiển thị địa chỉ IP và số hiệu cổng ở dạng số nguyên, không phân giải tên miền hoặc tên dịch vụ.
    • -l: Lọc và chỉ xuất các socket đang ở trạng thái lắng nghe (listening).
    • -p: Xuất tên chương trình cùng mã tiến trình (PID) đang dùng socket. Bạn cần chạy lệnh dưới quyền quản trị root hoặc thông qua sudo để đọc được thông tin tiến trình của người dùng khác.

    Dưới đây là đầu ra thực tế thu được trên máy chủ Ubuntu chạy SSH, Apache và MySQL:

    Kiểm Tra Cổng Đang Lắng Nghe Nhanh Chóng Bằng Lệnh ss
    Kiểm Tra Cổng Đang Lắng Nghe Nhanh Chóng Bằng Lệnh ss

    Phân tích các trường dữ liệu quan trọng trong kết quả

    • Netid: Hiển thị loại giao thức mạng của socket (TCP hoặc UDP).
    • State: Trạng thái kết nối. Cột này hiển thị LISTEN đối với các cổng TCP đang chờ kết nối. Với giao thức UDP vốn dĩ không duy trì trạng thái phiên (connectionless), trạng thái socket sẵn sàng nhận gói tin sẽ hiển thị là UNCONN.
    • Local Address:Port: Cột này phản ánh địa chỉ và cổng mà dịch vụ tiếp nhận. Ví dụ: MySQL chỉ bind vào 127.0.0.1:3306 nên chỉ máy cục bộ mới truy vấn được; cổng 22 của SSH bind vào 0.0.0.0:22 và [::]:22 trên toàn bộ card mạng; Apache lắng nghe tại *:80 bằng cơ chế dual-stack (nhận cả IPv4 và IPv6); còn hậu tố như %lo ám chỉ socket chỉ giới hạn trong card mạng loopback.
    • Process: Cho biết tên chương trình, PID và bộ mô tả tệp (fd). Ở cổng 22, ta thấy có cả sshd lẫn systemd với PID 1. Đây là cơ chế socket activation của systemd trên các bản Ubuntu mới, khi systemd mở socket trước rồi bàn giao cho daemon SSH, không phải lỗi tranh chấp. Để giảm nguy cơ bị quét cổng tự động, nhiều kỹ trị viên thường thực hiện thay đổi cổng SSH mặc định sang một dải số ngẫu nhiên.

    Bộ lọc chính xác trên lệnh ss

    Nếu muốn tìm cổng cụ thể như cổng 22, cách đơn giản là chuyển tiếp qua grep:

    sudo ss -tnlp | grep :22

    Tuy nhiên, lệnh ss có bộ lọc cú pháp riêng biệt cho hiệu suất cao hơn và không bị bắt nhầm các chuỗi chứa số 22 (chẳng hạn như port 2222):

    sudo ss -tlnp sport = :22

    Ngoài ra, khi cần giám sát các kết nối đang duy trì hoạt động trao đổi dữ liệu, bạn lọc theo trạng thái ESTABLISHED:

    ss -tn state established

    Kết quả trả về sẽ chỉ hiển thị các phiên đang hoạt động (ví dụ kết nối SSH từ IP 10.0.2.2), đồng thời cột State sẽ tự động ẩn đi vì mọi kết quả đều chung một trạng thái.

    3. Rà Soát Cổng Kết Nối Bằng Tiện Ích Truyền Thống netstat

    netstat là công cụ mạng dòng lệnh cổ điển đã đồng hành cùng Linux trong nhiều thập kỷ. Mặc dù hiện tại đã ngừng phát triển và bị coi là lỗi thời, netstat vẫn hiện diện phổ biến trên các hệ thống cũ hoặc trong thói quen xử lý của nhiều quản trị viên kỳ cựu.

    Vì không còn đi kèm mặc định trên các bản phân phối Linux mới, bạn cần cài đặt gói net-tools trước khi dùng:

    # Với Ubuntu, Debian và các bản phân phối liên quan:
    sudo apt install net-tools
    
    # Với RHEL, CentOS Stream, Fedora:
    sudo dnf install net-tools
    cài đặt gói net-tools trước khi dùng
    Cài đặt gói net-tools trước khi dùng

    Cú pháp kiểm tra tất cả cổng TCP/UDP đang lắng nghe với netstat hoàn toàn tương tự như ss:

    sudo netstat -tunlp

    Bảng kết quả trả về từ lệnh netstat:

    Active Internet connections (only servers)
    Proto Recv-Q Send-Q Local Address           Foreign Address         State       PID/Program name
    tcp        0      0 127.0.0.1:3306          0.0.0.0:*               LISTEN      3671/mysqld
    tcp        0      0 127.0.0.53:53           0.0.0.0:*               LISTEN      499/systemd-resolve
    tcp        0      0 127.0.0.1:33060         0.0.0.0:*               LISTEN      3671/mysqld
    tcp        0      0 127.0.0.54:53           0.0.0.0:*               LISTEN      499/systemd-resolve
    tcp        0      0 0.0.0.0:22              0.0.0.0:*               LISTEN      1/systemd
    tcp6       0      0 :::22                   :::*                    LISTEN      1/systemd
    tcp6       0      0 :::80                   :::*                    LISTEN      4370/apache2
    udp        0      0 127.0.0.54:53           0.0.0.0:*                           499/systemd-resolve
    udp        0      0 127.0.0.53:53           0.0.0.0:*                           499/systemd-resolve
    udp        0      0 10.0.2.15:68            0.0.0.0:*                           988/systemd-network
    udp        0      0 127.0.0.1:323           0.0.0.0:*                           1208/chronyd
    udp6       0      0 ::1:323                 :::*                                1208/chronyd

    So sánh sự khác nhau giữa đầu ra của netstat và ss

    • Giới hạn hiển thị tiến trình: netstat chỉ hiển thị duy nhất một tên tiến trình trên mỗi socket. Cổng 22 chỉ xuất hiện 1/systemd mà hoàn toàn không thể hiện sshd; dịch vụ Apache cũng chỉ hiển thị một tiến trình con đại diện thay vì toàn bộ các worker đang hoạt động.
    • Cột State ở giao thức UDP: netstat để trống cột trạng thái đối với các dòng socket UDP, trong khi ss định nghĩa rõ ràng trạng thái UNCONN.
    • Nhận diện socket dual-stack: Cổng 80 của Apache chỉ xuất hiện dưới dạng tcp6 với địa chỉ :::80, gây hiểu nhầm rằng cổng này không tiếp nhận IPv4 (mặc dù thực tế socket này vẫn xử lý lưu lượng IPv4 bình thường).

    Khi cần lọc một cổng cụ thể với netstat:

    sudo netstat -tnlp | grep :22

    Nếu lệnh không xuất bất kỳ kết quả nào, nghĩa là hệ thống không có ứng dụng nào lắng nghe trên cổng 22. Để kiểm tra xem cổng có thông từ bên ngoài mạng hay không, bạn nên dùng netcat (nc) từ một máy chủ từ xa.

    4. Truy Vết Tiến Trình Chiếm Giữ Socket Bằng Lệnh lsof

    Trong hệ điều hành Linux, mọi tài nguyên kết nối đều được xem như tệp tin (Everything is a file), và socket mạng cũng không phải là ngoại lệ. Lệnh lsof (Liệt kê các tệp đang mở) là công cụ cực kỳ lợi hại giúp bạn xác định chuẩn xác ứng dụng và tài khoản nào đang giữ quyền kiểm soát cổng mạng.

    Truy Vết Tiến Trình Chiếm Giữ Socket Bằng Lệnh lsof

    Cài đặt lsof nếu máy chủ chưa có sẵn:

    # Cho hệ điều hành Debian / Ubuntu:
    sudo apt install lsof
    
    # Cho hệ điều hành RHEL / CentOS:
    sudo dnf install lsof

    Để truy xuất danh sách toàn bộ các cổng TCP đang lắng nghe:

    sudo lsof -nP -iTCP -sTCP:LISTEN

    Các tham số cần lưu ý:

    • -n: Ngăn việc phân giải ngược tên miền (IP sang hostname) để tăng tốc độ truy vấn.
    • -P: Ngăn việc chuyển đổi số hiệu cổng thành tên dịch vụ quen thuộc (giữ nguyên số 80 thay vì chữ http).
    • -iTCP -sTCP:LISTEN: Bộ lọc chuyên biệt chỉ hiển thị các tệp mạng TCP đang duy trì trạng thái LISTEN.

    Đầu ra chi tiết của lệnh lsof:

    COMMAND    PID            USER  FD   TYPE DEVICE SIZE/OFF NODE NAME
    systemd      1            root 358u  IPv4  18858      0t0  TCP *:22 (LISTEN)
    systemd      1            root 359u  IPv6  18860      0t0  TCP *:22 (LISTEN)
    systemd-r  499 systemd-resolve  17u  IPv4  10129      0t0  TCP 127.0.0.53:53 (LISTEN)
    systemd-r  499 systemd-resolve  19u  IPv4  10131      0t0  TCP 127.0.0.54:53 (LISTEN)
    sshd      1309            root   3u  IPv4  18858      0t0  TCP *:22 (LISTEN)
    sshd      1309            root   4u  IPv6  18860      0t0  TCP *:22 (LISTEN)
    mysqld    3671           mysql  19u  IPv4  27468      0t0  TCP 127.0.0.1:33060 (LISTEN)
    mysqld    3671           mysql  22u  IPv4  31568      0t0  TCP 127.0.0.1:3306 (LISTEN)
    apache2   4370            root   4u  IPv6  32272      0t0  TCP *:80 (LISTEN)
    apache2   4386        www-data   4u  IPv6  32272      0t0  TCP *:80 (LISTEN)
    apache2   4387        www-data   4u  IPv6  32272      0t0  TCP *:80 (LISTEN)

    Các cột thông tin chính bao gồm:

    • COMMAND, PID, USER: Tên tiến trình (lưu ý lsof tự động rút ngắn các tên dài như systemd-resolve thành systemd-r), mã định danh PID và quyền người dùng thực thi. Cột USER cho thấy tiến trình cha của Apache chạy quyền root, trong khi các tiến trình worker xử lý web chạy dưới quyền www-data.
    • NAME: Địa chỉ IP, số cổng và trạng thái socket. Ký hiệu dấu sao (*) thể hiện ứng dụng lắng nghe trên toàn bộ giao diện mạng.

    Các mẹo lọc hữu ích với lsof

    Để xem mọi tiến trình đang can thiệp vào một cổng cụ thể (ví dụ port 80):

    sudo lsof -i :80

    Lưu ý: Khi thiếu cờ -P, tên cổng 80 sẽ tự động dịch sang http. Cú pháp -i :80 sẽ khớp cả kết nối TCP/UDP ở mọi trạng thái kết nối chứ không chỉ riêng trạng thái lắng nghe.

    Để chỉ lọc đúng tiến trình đang lắng nghe trên cổng 3306 (MySQL):

    sudo lsof -nP -iTCP:3306 -sTCP:LISTEN

    Nếu bạn muốn tìm dịch vụ chạy giao thức UDP qua lsof, hãy bỏ qua bộ lọc -s vì UDP không có trạng thái LISTEN:

    sudo lsof -nP -iUDP

    5. Những Sai Lầm Phổ Biến Khi Rà Soát Cổng Mạng Trên Linux

    Trong quá trình xử lý sự cố mạng thực tế, người quản trị thường gặp phải những thiếu sót phổ biến khiến kết quả đầu ra bị sai lệch hoặc thiếu thông tin quan trọng:

    • Không sử dụng quyền sudo: Thiếu quyền root đồng nghĩa với việc cờ -p không thể truy xuất thông tin tiến trình của người dùng khác. Kết quả là cổng mạng vẫn hiện lên nhưng cột tên chương trình và PID hoàn toàn trống trơn. Với lsof, chạy với tài khoản thường chỉ hiển thị các tiến trình thuộc quyền cá nhân bạn.
    • Bỏ quên cờ -l (lắng nghe): Nếu không có tham số -l, cả ss và netstat sẽ in ra toàn bộ kết nối hiện hữu của hệ thống (bao gồm hàng trăm kết nối ESTABLISHED, TIME_WAIT…), gây rối loạn và che lấp các cổng dịch vụ bạn đang cần kiểm tra.
    • Cố tìm socket UDP bằng từ khóa LISTEN: UDP là giao thức connectionless nên socket UDP hiển thị là UNCONN trên ss và để trống trên netstat. Nếu bạn dùng lệnh dạng grep LISTEN, toàn bộ socket UDP (chẳng hạn như dịch vụ đồng bộ thời gian chronyd cổng 323) sẽ bị loại bỏ hoàn toàn khỏi bảng kết quả.
    • Quên dấu hai chấm khi grep số hiệu cổng: Cú pháp tìm kiếm luôn phải có dấu hai chấm đứng trước số cổng (ví dụ: grep :22). Nếu bạn chỉ gõ grep 22, hệ thống sẽ lọc cả những dòng chứa PID, cổng cục bộ ngẫu nhiên hoặc các số liệu thống kê vô tình chứa số 22.
    • Bỏ sót tường lửa hệ điều hành: Khi dịch vụ đã lắng nghe nhưng bên ngoài không thể kết nối, hãy kiểm tra lại cấu hình tường lửa; bạn có thể tham khảo hướng dẫn thiết lập tường lửa UFW trên Ubuntu để đảm bảo quy tắc cho phép lưu lượng truy cập đã được kích hoạt chính xác.

    6. Bảng Tra Cứu Nhanh Cheat Sheet Lệnh Kiểm Tra Port

    Bảng tổng hợp dưới đây giúp bạn nhanh chóng tra cứu câu lệnh chính xác cho từng mục đích kiểm tra cụ thể mà không cần phải ghi nhớ toàn bộ tham số phức tạp:

    Nhu Cầu Kiểm Tra Cụ Thể Lệnh Linux Tương Ứng Cần Thực Thi
    Liệt kê tất cả các listening port (khuyên dùng) sudo ss -tunlp
    Chỉ liệt kê các port UDP đang lắng nghe sudo ss -unlp
    Liệt kê tất cả listening port bằng netstat sudo netstat -tunlp
    Lọc tiến trình theo cổng bằng bộ lọc ss sudo ss -tlnp sport = :80
    Lọc tiến trình theo cổng bằng ss + grep sudo ss -tnlp | grep :80
    Tìm tất cả tiến trình liên quan cổng 80 qua lsof sudo lsof -i :80
    Liệt kê cổng TCP đang lắng nghe bằng lsof sudo lsof -nP -iTCP -sTCP:LISTEN
    Tìm tiến trình chiếm cổng 3306 qua lsof sudo lsof -nP -iTCP:3306 -sTCP:LISTEN
    Hiển thị các kết nối đang duy trì (established) ss -tn state established
    Hiển thị toàn bộ kết nối mạng kèm tiến trình sudo ss -tunp

    Các thao tác trên đều là những cú pháp dòng lệnh quen thuộc trong bộ tổng hợp lệnh Linux cơ bản mà mọi sysadmin đều nên ghi nhớ.

    7. Câu Hỏi Thường Gặp Về Quản Trị Cổng Mạng Linux (FAQ)

    Sự khác nhau cơ bản giữa lệnh ss và netstat là gì?

    Cả hai công cụ đều xuất thông tin socket mạng. Tuy nhiên, ss là công cụ hiện đại, truy xuất trực tiếp qua netlink kernel nên tốc độ nhanh hơn vượt trội, phân tích trạng thái TCP sâu hơn và được cài mặc định. netstat đọc dữ liệu từ tệp /proc, tốc độ chậm khi có nhiều kết nối và hiện đã bị xem là lỗi thời.

    Vì sao cột tiến trình (Process/PID) bị trống khi chạy lệnh?

    Hệ thống Linux ngăn chặn người dùng thông thường xem thông tin tiến trình của tài khoản khác nhằm đảm bảo an toàn. Bạn bắt buộc phải thêm sudo vào trước lệnh hoặc đăng nhập bằng tài khoản root thì mới quan sát được đầy đủ dữ liệu tiến trình sở hữu cổng.

    Làm thế nào để kiểm tra một cổng có đang mở từ bên ngoài Internet?

    Các lệnh trong bài viết chỉ phản ánh trạng thái lắng nghe nội bộ máy chủ. Để kiểm tra tính khả dụng từ một máy tính từ xa, bạn nên sử dụng lệnh nc -zv <IP_máy_chủ> <port> hoặc quét bằng phần mềm nmap để xác định xem cổng có bị tường lửa chặn hay không.

    Hai dịch vụ có thể cùng lắng nghe trên một cổng duy nhất không?

    Về cơ bản là không thể; hai dịch vụ độc lập không thể bind đồng thời vào cùng một cổng, IP và giao thức. Trường hợp ngoại lệ là khi các ứng dụng cùng sử dụng cờ SO_REUSEPORT của nhân Linux để chia tải kết nối, hoặc cơ chế socket activation của systemd tiếp nhận socket trước rồi bàn giao lại cho dịch vụ như sshd.

    Tổng Kết Kỹ Năng Kiểm Tra Listening Ports

    Nắm vững Cách Kiểm Tra Port Đang Lắng Nghe Trong Linux Chi Tiết: Sử Dụng Lệnh ss, netstat và lsof giúp bạn làm chủ hoàn toàn các kết nối mạng, nhanh chóng khắc phục lỗi xung đột ứng dụng và chủ động bảo vệ an ninh máy chủ. Trong vận hành thực tế, ss luôn là ưu tiên số một cho tốc độ, lsof hỗ trợ đắc lực khi cần bóc tách file descriptor và tiến trình, còn netstat là phương án dự phòng trên hệ thống cũ. Hãy ghi nhớ luôn chạy lệnh với quyền sudo và kiểm tra kỹ quy tắc tường lửa mỗi khi triển khai dịch vụ mới.

    Cần một VPS giá rẻ để bắt đầu?

    Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.

    Xem bảng giá VPS

    Lưu ý: Toàn bộ nội dung hướng dẫn trên được cung cấp nhằm mục đích tham khảo kỹ thuật. Các câu lệnh, tham số và đầu ra hiển thị có thể thay đổi tùy thuộc vào phiên bản nhân Linux, bản phân phối cụ thể cũng như môi trường vận hành thực tế. Bạn nên kiểm thử cẩn trọng trên môi trường thử nghiệm và sao lưu dữ liệu an toàn trước khi áp dụng trên các hệ thống production.